La synthèse vocale (TTS, pour « text to speech ») lit un texte à voix haute avec une voix de synthèse. Certaines savent imiter une voix réelle à partir de quelques secondes ou de quelques minutes d’enregistrement. C’est utile pour écouter un article en marchant, rendre un document accessible, ou donner une voix à une vidéo.
Comment ça marche
Le modèle découpe le texte en sons (les phonèmes), décide de la mélodie de la phrase, puis fabrique le signal audio. Il lit avec une voix de son catalogue, ou avec une voix clonée : on lui fournit des enregistrements d’une personne, et il en reproduit le timbre. Le clonage instantané se contente d’une à deux minutes d’audio chez ElevenLabs ; le clonage professionnel, pour un résultat plus fidèle, demande de trente minutes à trois heures.
À quoi ça sert
- Écouter au lieu de lire. Un article, un PDF, un livre numérique, en voiture ou en marchant.
- Accessibilité. Une aide pour une personne malvoyante, dyslexique ou fatiguée de l’écran.
- Voix off. Commenter une vidéo, une présentation ou un tutoriel sans enregistrer sa voix.
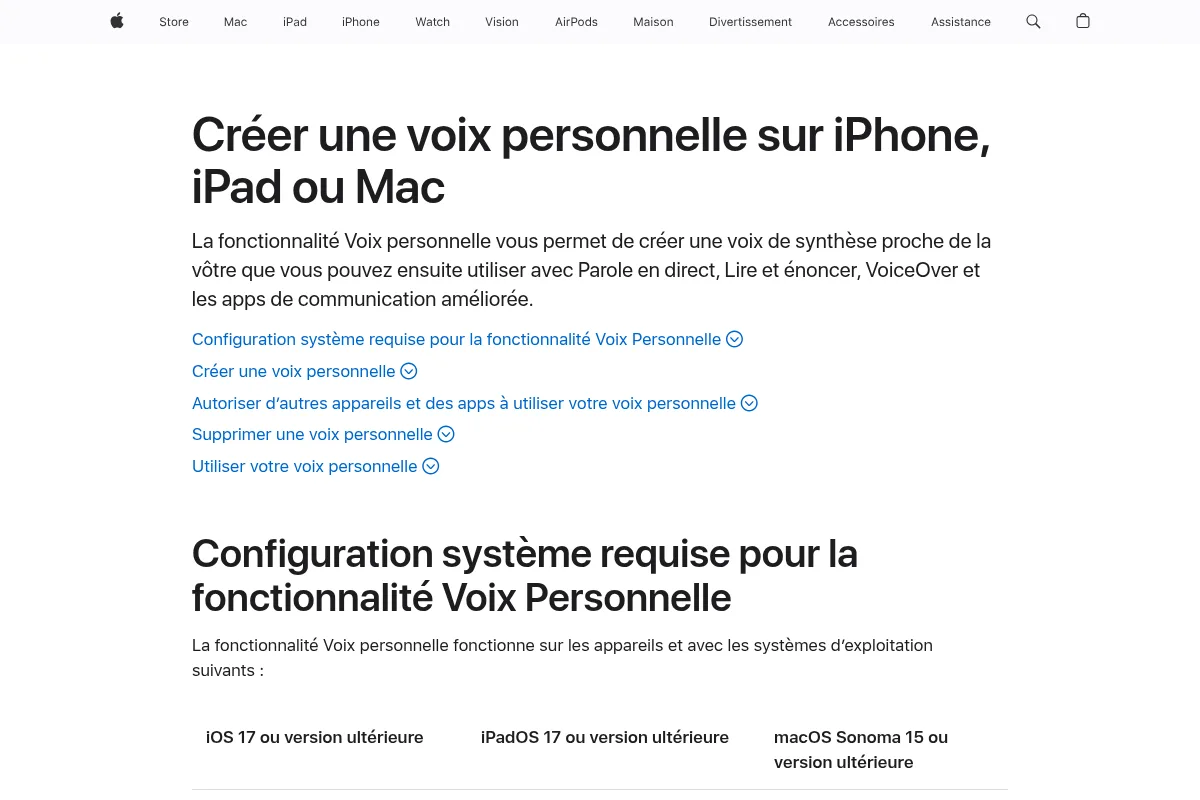
- Parler avec sa propre voix. La Voix personnelle d’Apple crée une voix de synthèse proche de la vôtre, utilisable par les fonctions d’accessibilité.
Les outils
Sur le téléphone et l’ordinateur. Les applis de lecture comme ElevenReader ou Speechify lisent PDF, pages web et livres numériques avec des voix de synthèse ; elles calculent la voix sur leurs serveurs. Sur Android, Gemini Nano sait aussi synthétiser la parole sur l’appareil pour les applis qui s’en servent.
Les plateformes de voix. ElevenLabs propose des milliers de voix dans plus de 70 langues, le clonage et le doublage. Mistral sert par son API Voxtral TTS, qui imite une voix à partir d’un court extrait.
En local. Piper, libre, tourne vite même sur une petite machine et parle français. Pocket TTS, de Kyutai, tourne sur un processeur ordinaire, parle français et sait cloner une voix à partir d’un extrait.
Lire à voix haute et synthèse vocale
- ElevenLabsElevenLabs, États-Uniscode fermé
- ElevenReaderElevenLabs, États-Uniscode fermé
- PiperOpen Home Foundationopen source (GPL-3.0)
- SpeechifySpeechify, États-Uniscode fermé
Rangés par ordre alphabétique, sans note ni classement.
Notre classement de la synthèse vocale en français, établi par les votes d’écoute et la prononciation :
Synthèse vocale : le haut du classement en français
- Eleven v4ElevenLabs1 351
- Sonic 3.6Cartesia1 336
- Eleven v4 TurboElevenLabs1 310
- Eleven v3ElevenLabs1 264
- v3 ConversationalElevenLabs1 259
Synthèse vocale en français, en Elo. Source : Artificial Analysis, relevé du 16 novembre 2026.
Créer sa Voix personnelle sur iPhone, iPad ou Mac
Apple propose une voix de synthèse qui ressemble à la vôtre, calculée sur l’appareil, pour Parole en direct, Lire et énoncer, VoiceOver et les applis de communication. Il faut iOS 17, iPadOS 17 ou macOS Sonoma ou plus récent, un iPhone 12 ou plus récent ou un Mac à puce Apple, et un code, Face ID ou Touch ID configuré.
- Ouvrez Réglages, puis Accessibilité, puis Voix personnelle (sur Mac : Réglages Système, Accessibilité, Voix personnelle).
- Touchez Créer une Voix personnelle.
- Lisez à voix haute les phrases affichées, avec le micro de l’appareil ou un micro externe. Vous pouvez faire une pause : la progression est gardée.
- Attendez la notification : l’appareil prépare la voix lui-même.
La voix est chiffrée et rangée sur l’appareil. Apple la réserve à un usage personnel et non commercial, et sa suppression est définitive.
Pas à pas avec Piper, en local
Piper s’installe avec Python, sur Linux, Mac et Windows. Il embarque espeak-ng pour transformer le texte en sons.
-
Installez Piper :
pip install piper-tts -
Téléchargez une voix française. Les voix sont rangées sur Hugging Face par langue (
fr_FRpour le français de France : siwis, tom, upmc, gilles, mls). Par exemple :python3 -m piper.download_voices fr_FR-siwis-medium -
Faites lire une phrase et enregistrez-la dans un fichier :
python3 -m piper -m fr_FR-siwis-medium -f essai.wav -- 'Bonjour, ceci est un essai de synthèse vocale.' -
Vérifiez la licence de la voix dans son fichier
MODEL_CARD: Piper prévient que certaines voix ont des licences restrictives. La voix siwis, par exemple, vient d’un jeu de données sous licence CC BY 4.0.
Installer Piper
- Gestionnaire de paquets pip install piper-tts (Intel et Apple Silicon) · relevé le 17 octobre 2026
- Gestionnaire de paquets pip install piper-tts (x64) · relevé le 17 octobre 2026
- Gestionnaire de paquets pip install piper-tts (x86_64 et ARM64) · relevé le 17 octobre 2026
- Dépôt officiel Paquets Python publiés avec chaque version · relevé le 17 octobre 2026
Bon à savoir. Lancé ainsi, Piper recharge la voix à chaque phrase, ce qui est lent. Pour un usage régulier, sa documentation conseille son serveur web.
Cloner une voix : les précautions
- Ne clonez que votre voix, ou celle d’une personne qui a donné son accord. ElevenLabs limite le clonage professionnel à votre propre voix, avec une étape de vérification. Sa documentation ne décrit pas de vérification pour le clonage instantané : la responsabilité vous revient.
- Gardez une trace de l’accord : un écrit qui dit pour quel usage la voix peut servir, et combien de temps.
- Signalez la voix générée quand vous la diffusez. En France, diffuser sans son consentement un contenu sonore généré qui reproduit les paroles d’une personne, sans que ce soit évident ou signalé, est puni d’un an de prison et de 15 000 € d’amende, deux ans et 45 000 € en ligne (article 226-8 du Code pénal). Le règlement européen sur l’IA demande aussi, depuis le 2 août 2026, de dire qu’un hypertrucage audio est généré.
- Méfiez-vous des appels. Une voix connue au téléphone ne prouve plus l’identité de quelqu’un : en cas de demande urgente d’argent, rappelez la personne sur son numéro habituel.
Pour aller plus loin
- Transcrire un enregistrement en texte, en ligne ou en localNiveau Amateur 18 min
- L'IA sur Linux : Ollama en service, interfaces et outilsNiveau Amateur 20 min
- Voxtral de Mistral : transcrire et faire parler une voixNiveau Amateur 13 min
Pour monter son atelier d'IA à la maison, mini lab AI, du même auteur, va plus loin.
Sources
- support.apple.com, lue le
- github.com, lue le
- raw.githubusercontent.com, lue le
- raw.githubusercontent.com, lue le
- huggingface.co, lue le
- elevenlabs.io, lue le
- developer.android.com, lue le
- legifrance.gouv.fr, lue le
- artificialintelligenceact.eu, lue le
- apps.apple.com, lue le