Aller au contenu
EN 4 QUESTIONSTrouver mon modèle
Kit pour les articles · édition du

Édition du mois

Les graphiques et les tableaux de l'édition courante, prêts à reprendre dans un article : 4 images en PNG, 2 tableaux à coller dans WordPress et un bloc à intégrer. Tout se recalcule à chaque édition.

Les graphiques?

Fond nuit, violet pour les modèles, vert pour le modèle du sujet : Gemini 4 Carbon, premier du classement. Chaque image se télécharge en PNG, deux fois plus grande que son cadre.

Graphique A

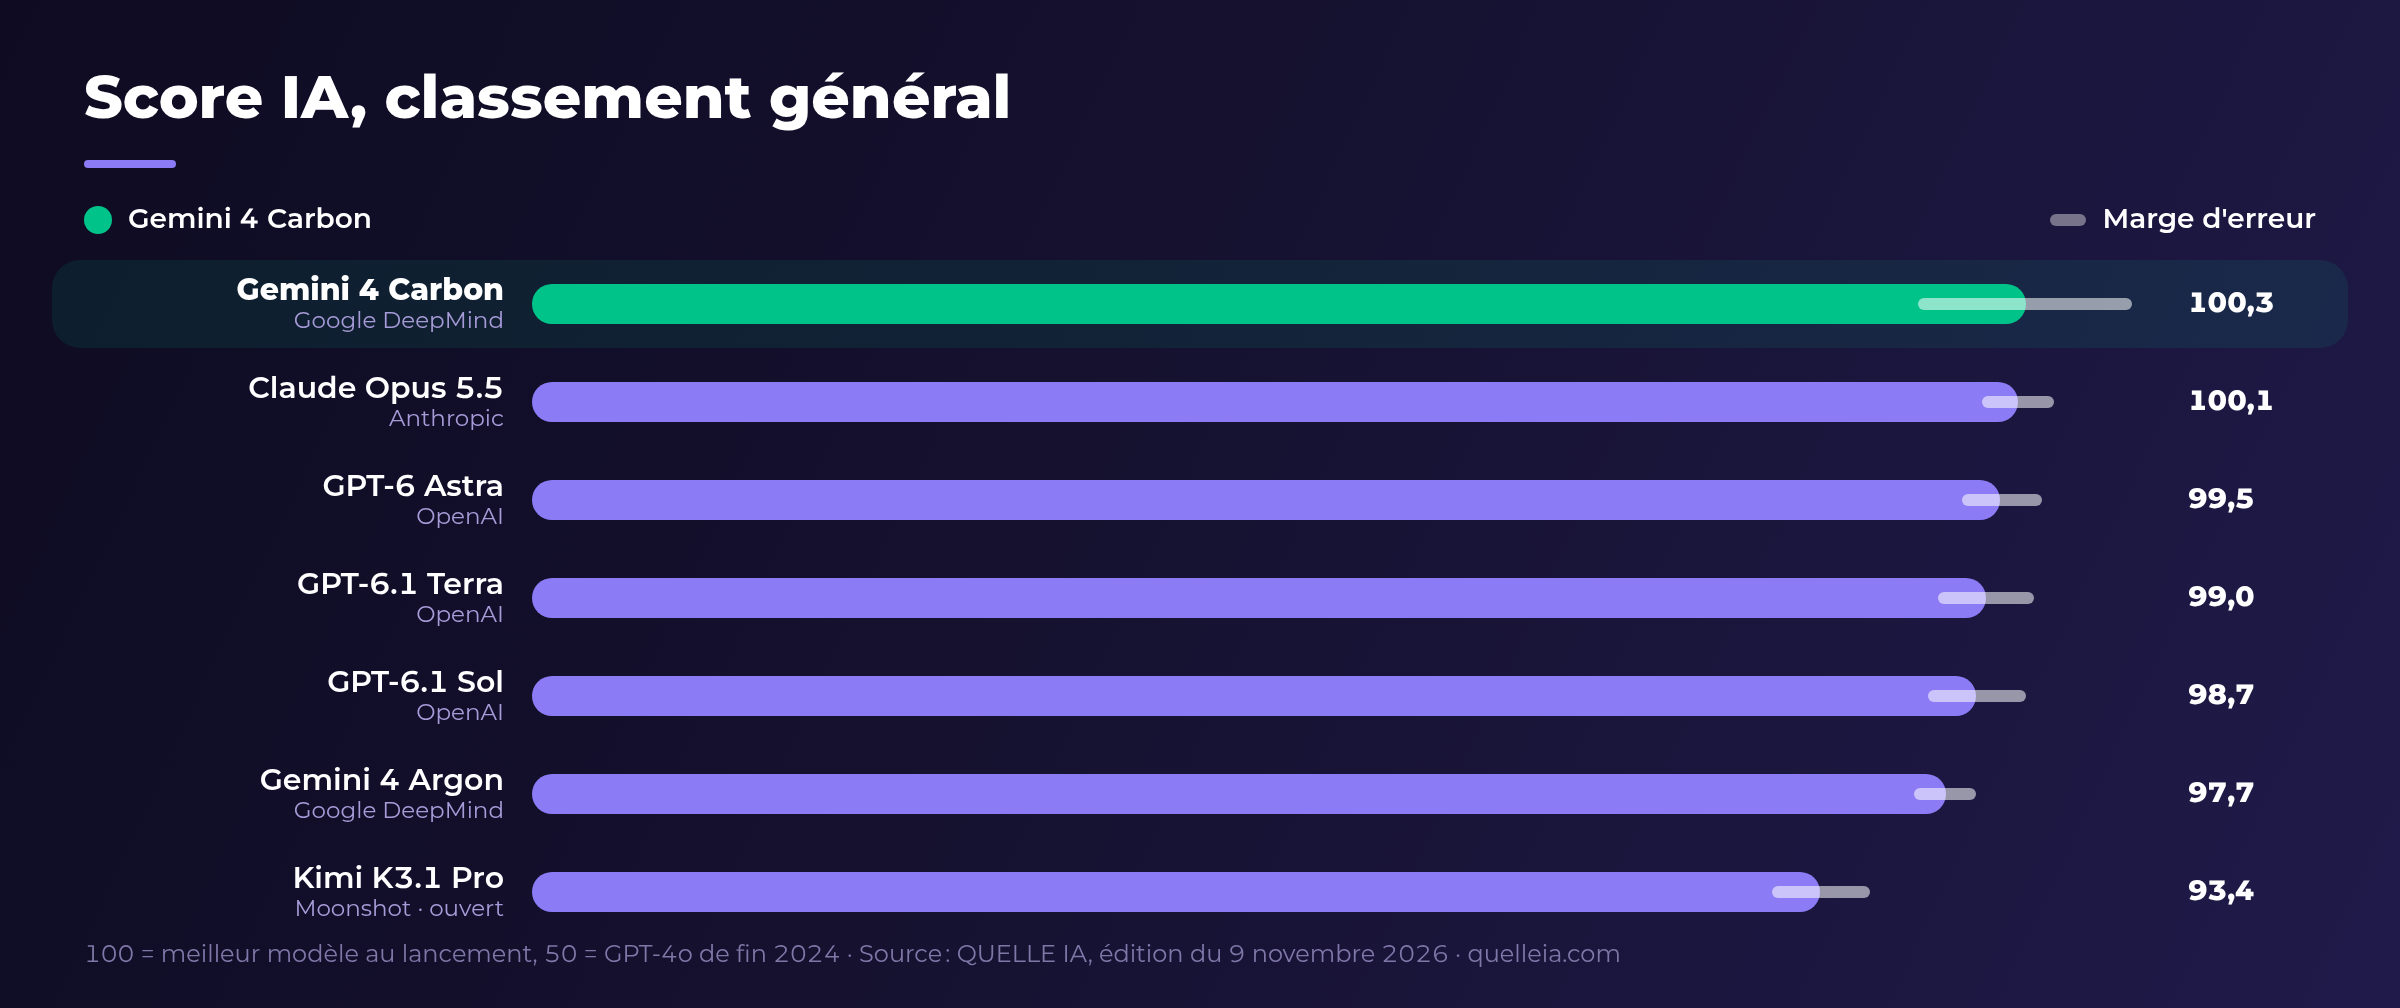
Classement en barres, avec marge

1 200 × 504

Gemini 4 Carbon est en tête du classement général de l'édition du 9 novembre 2026, avec un score IA de 100,3 et une marge de 96,7 à 103,9. Les huit premiers sont ex æquo. Le premier modèle aux poids ouverts, Kimi K3.1 Pro, est au rang 14 avec 93,4.

Graphique B

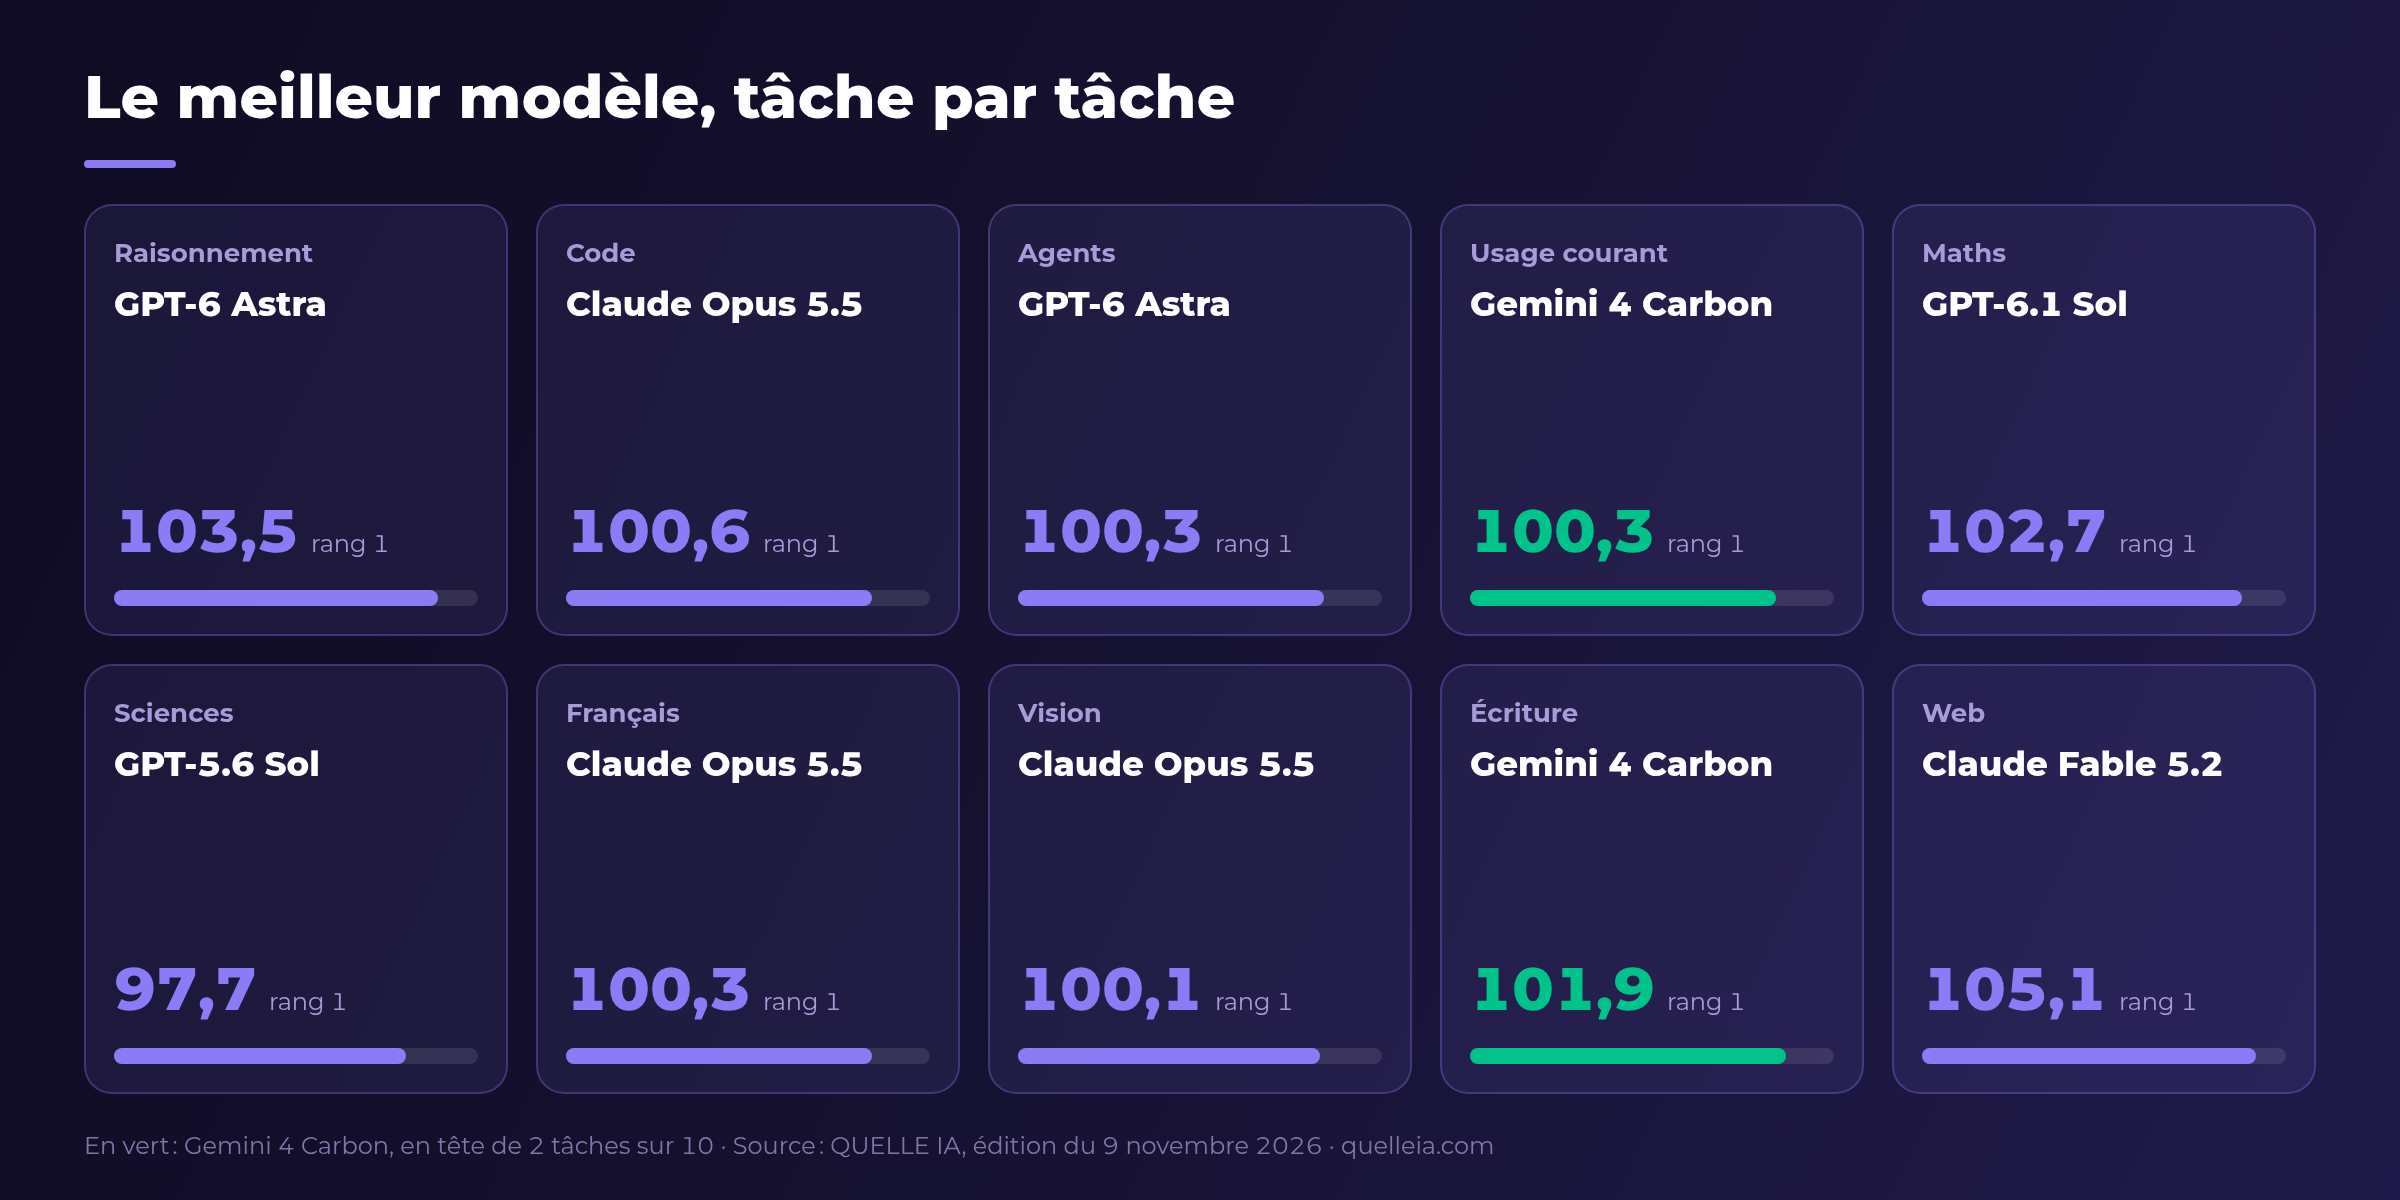
Le meilleur modèle par tâche

1 200 × 600

Gemini 4 Carbon est en tête de 2 tâches sur 10 : usage courant et écriture. GPT-6 Astra, Claude Opus 5.5, GPT-6.1 Sol, GPT-5.6 Sol et Claude Fable 5.2 se partagent les autres.

Graphique C

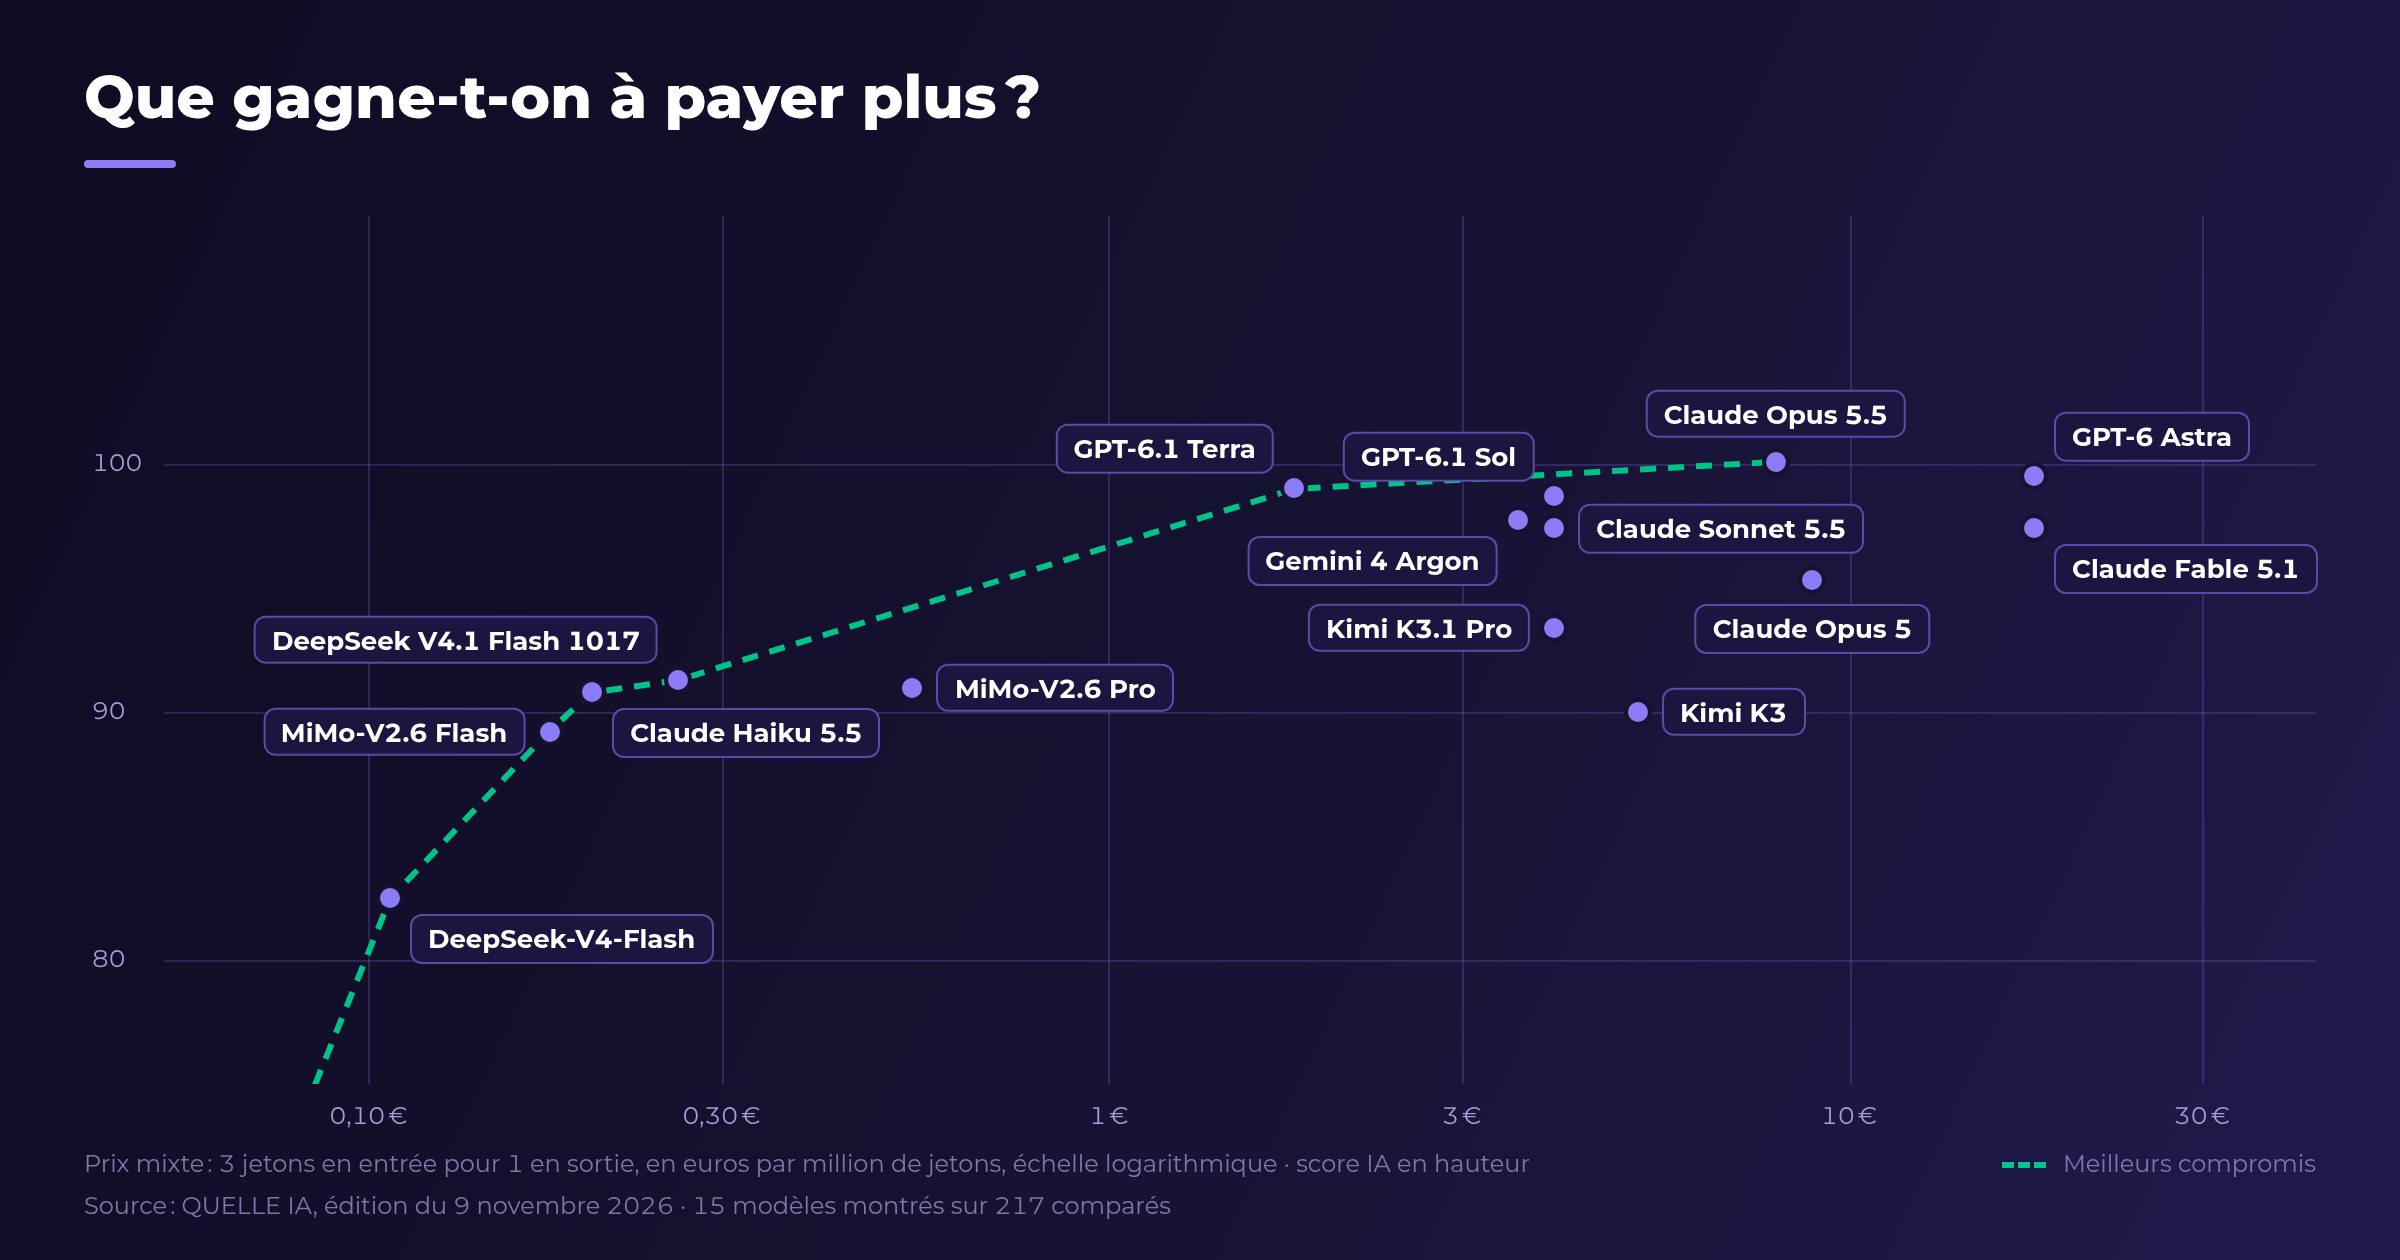
Le prix de la performance

1 200 × 630

En moyenne, un modèle dix fois plus cher gagne 10,4 points de score IA, d'après 106 modèles. Dix modèles sont les meilleurs compromis : aucun autre modèle ne fait mieux pour moins cher. Au-dessus de 95, le moins cher est GPT-6.1 Terra, à 1,78 € le million de jetons en prix mixte.

Graphique D

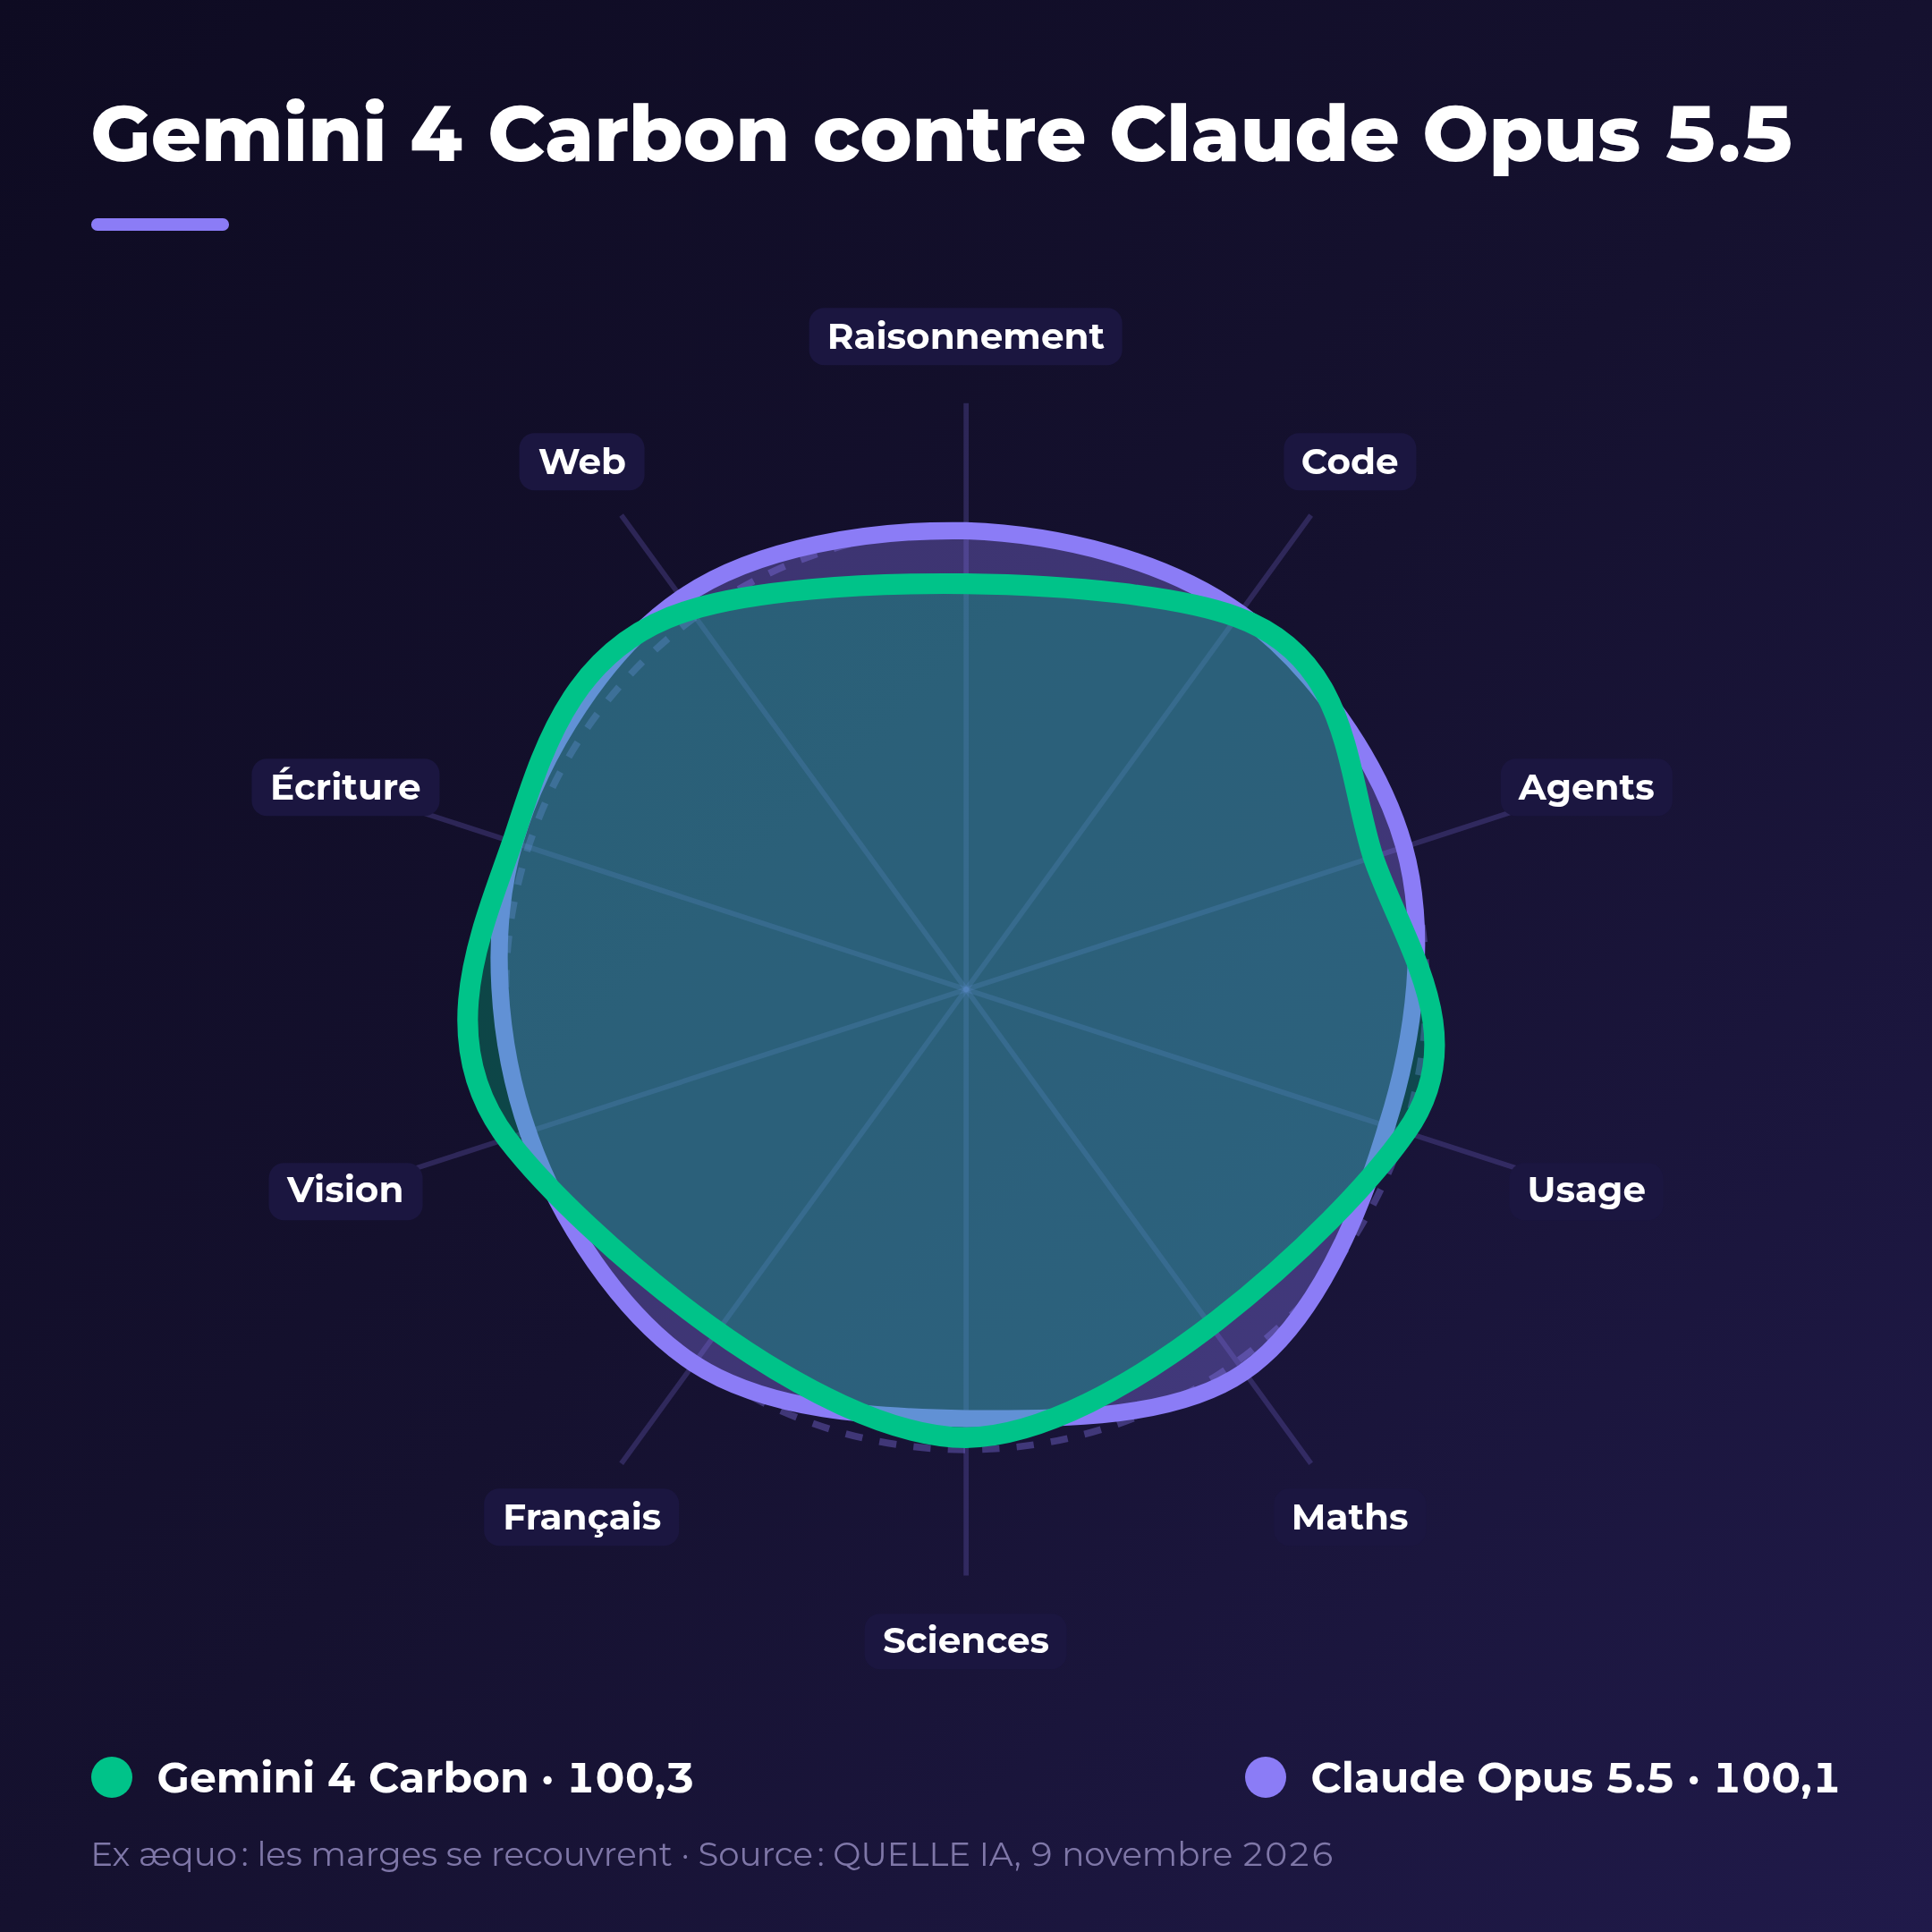
Duel d'empreintes

1 080 × 1 080

Gemini 4 Carbon (100,3) face à Claude Opus 5.5 (100,1) : ils sont ex æquo, trop proches pour être départagés. Sur les sept tâches mesurées chez les deux, Gemini 4 Carbon fait mieux sur quatre (usage courant, sciences, vision et écriture) et Claude Opus 5.5 fait mieux sur trois (code, agents et web).

Scores par tâche de Gemini 4 Carbon et de Claude Opus 5.5, édition du 9 novembre 2026
TâcheGemini 4 CarbonClaude Opus 5.5
Raisonnement99,8
Code100,1*100,6
Agents96,6*100,1
Usage courant100,398,2
Maths101,4
Sciences98,7*96,6
Français100,3
Vision102,5*100,1
Écriture101,9101,7
Web101,1102,7

* Score provisoire : trop peu de mesures sur cette tâche pour donner un rang.

Les tableaux?

À coller dans WordPress, dans un bloc « HTML personnalisé » : des balises de tableau et des styles en ligne, sans classe, sans feuille de style, sans script. Le tableau complet vise une colonne d'article sur ordinateur, le compact reste lisible à 320 px.

Tableau E

Tableau complet

Colonne de 680 px

Texte de l'article. Le tableau est collé dans WordPress : balises de tableau et styles en ligne uniquement.

Score IA, classement général
RangModèleScore IAPrix / M
1Gemini 4 CarbonGoogle DeepMind100,3
1Claude Opus 5.5Anthropic100,14 € / 20 €
1GPT-6 AstraOpenAI99,58,92 € / 44,60 €
1GPT-6.1 TerraOpenAI99,00,89 € / 4,46 €
1GPT-6.1 SolOpenAI98,72 € / 10 €
1Gemini 4 ArgonGoogle DeepMind97,71,78 € / 8,92 €
14Kimi K3.1 ProMoonshot · ouvert93,42 € / 10 €
Les huit premiers sont ex æquo. Prix en euros par million de jetons, en entrée puis en sortie. Source : QUELLE IA, édition du 9 novembre 2026.

Tableau F

Tableau compact

Colonne de 320 px
Score IA, classement général
1Gemini 4 Carbon100,3
1Claude Opus 5.5100,1
1GPT-6 Astra99,5
1GPT-6.1 Terra99,0
1GPT-6.1 Sol98,7
1Gemini 4 Argon97,7
14Kimi K3.1 Pro93,4
Source : QUELLE IA, 9 novembre 2026

Citer la source

Citez « QUELLE IA, édition du 9 novembre 2026 » sous chaque image ou tableau repris, avec un lien vers quelleia.com.

La mention figure déjà dans les images et dans les tableaux : gardez-la quand vous les recadrez ou les adaptez.
Le bloc à intégrer

Un cadre <iframe> avec le haut du classement général. Il se met à jour seul à chaque édition et renvoie vers la fiche de chaque modèle.

Bloc
Identité du bloc

Pour l'identité nuit, ajoutez ?theme=nuit à l'adresse du cadre. La hauteur de 468 px convient de 300 à 720 px de large.

En bref

Quel est le meilleur modèle de langage dans l'édition du 9 novembre 2026 ?
Gemini 4 Carbon est en tête du classement général de QUELLE IA avec un score IA de 100,3, dans une marge de 96,7 à 103,9. Huit modèles sont ex æquo en tête, car leurs marges se recouvrent : Gemini 4 Carbon, Claude Opus 5.5, GPT-6 Astra, GPT-6.1 Terra, GPT-6.1 Sol, Gemini 4 Argon, Claude Fable 5.1 et Claude Sonnet 5.5.
Quel modèle est le meilleur pour chaque tâche ?
Raisonnement : GPT-6 Astra (103,5) ; Code : Claude Opus 5.5 (100,6) ; Agents : GPT-6 Astra (100,3) ; Usage courant : Gemini 4 Carbon (100,3) ; Maths : GPT-6.1 Sol (102,7) ; Sciences : GPT-5.6 Sol (97,7) ; Français : Claude Opus 5.5 (100,3) ; Vision : Claude Opus 5.5 (100,1) ; Écriture : Gemini 4 Carbon (101,9) ; Web : Claude Fable 5.2 (105,1). Seuls les modèles classés sur une tâche sont retenus.
Que gagne-t-on à payer un modèle plus cher ?
En moyenne, un modèle dix fois plus cher gagne 10,4 points de score IA, d'après 106 modèles. Dix modèles sont les meilleurs compromis : aucun autre modèle ne fait mieux pour moins cher. Au-dessus de 95, le moins cher est GPT-6.1 Terra, à 1,78 € le million de jetons en prix mixte.
Peut-on reprendre ces graphiques et ces tableaux ?
Oui, librement, dans un article, une présentation ou un réseau social. Citez « QUELLE IA, édition du 9 novembre 2026 » sous chaque image ou tableau repris, avec un lien vers quelleia.com. La mention figure déjà dans les images et dans les tableaux : gardez-la quand vous les recadrez ou les adaptez.