Quand un benchmark d’agents publie le score d’un modèle, il mesure en réalité un couple : le modèle et le programme qui l’a piloté pendant l’épreuve. Les bancs d’essai appellent ce programme le harnais. Il donne la tâche au modèle, exécute les commandes que le modèle demande, lui renvoie les résultats et décide quand s’arrêter. Changez de harnais, et le même modèle réussit plus ou moins de tâches.
Anthropic le résume en une ligne dans un article technique d’avril 2026 : le harnais est « la boucle qui appelle Claude et achemine ses appels d’outils vers l’infrastructure ». Le même texte ajoute que les harnais « encodent des hypothèses sur ce que Claude ne sait pas faire seul ».
Ce que le harnais décide à la place du modèle
Un modèle de langage ne fait qu’une chose : produire du texte à partir du texte qu’on lui donne. Tout le reste vient du harnais.
- Les consignes. Avant votre demande, le harnais envoie au modèle un long texte de règles : comment lire un fichier, quand demander l’autorisation, comment présenter un changement. Deux outils n’écrivent jamais ce texte de la même façon.
- Les outils. Le harnais choisit ce que le modèle peut faire (lire, chercher, écrire, lancer une commande, ouvrir une page web) et la façon dont chaque outil est décrit. Un outil mal décrit est mal utilisé.
- La boucle. Après chaque action, le harnais renvoie le résultat au modèle. Il peut tronquer une sortie trop longue, relancer après une erreur, lancer les tests ou fixer un nombre maximal d’étapes.
- La mémoire. Le contexte d’un modèle a une taille limite. Le harnais décide quoi garder quand il déborde : résumer la conversation, relire un fichier de notes, confier une recherche à un sous-agent qui ne rapporte que sa conclusion.
- Les garde-fous. Permissions, bac à sable, budget de temps ou d’argent : tout cela change ce que le modèle ose tenter.
Le budget d’étapes suffit à changer un score. Sur OSWorld, un banc où l’agent pilote un ordinateur, un même modèle apparaît avec 15, 50 ou 100 étapes autorisées, dans le même outil. QUELLE IA l’a retiré de son comparateur d’outils pour cette raison : les lignes d’un même modèle y diffèrent par le budget d’étapes, avec un outil identique.
Un exemple tiré des laboratoires
En novembre 2025, une équipe d’Anthropic a décrit comment elle a fait construire une application web entière par Claude sur de nombreuses sessions. Avec une simple consigne de départ, le modèle tentait de tout faire d’un coup, manquait de contexte au milieu d’une fonction et laissait la session suivante deviner ce qui s’était passé.
L’équipe n’a pas changé de modèle. Elle a changé le harnais : une première session prépare le projet, écrit un script de démarrage, un fichier de progression et une liste de plus de 200 fonctions à réaliser, toutes marquées « à faire ». Chaque session suivante relit ces notes et l’historique Git, choisit une seule fonction, la teste comme le ferait un utilisateur dans le navigateur, puis enregistre son travail. Les échecs qu’elle observait (déclarer le projet fini trop tôt, laisser des bogues non notés) ont reculé.
Ce que montrent les classements
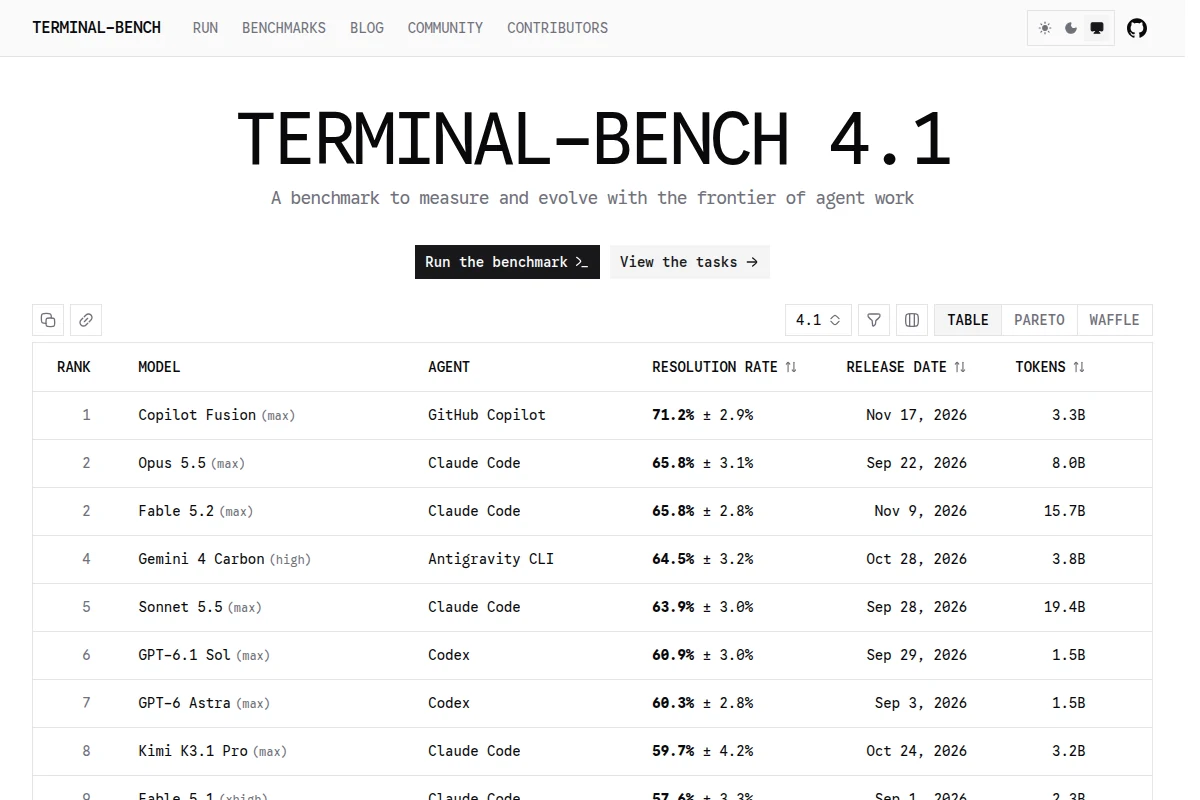
Les classements d’agents le disent eux-mêmes. Celui de Terminal-Bench, un banc de tâches en ligne de commande, affiche une colonne « Agent » à côté de la colonne « Model ».
QUELLE IA rassemble ces mesures sur une page, Le même modèle, des outils différents : chaque barre est le même modèle sur le même benchmark, avec un outil différent.
Ces chiffres valent pour un jour et une version. Un outil change souvent, parfois chaque semaine, et un classement ne dit jamais ce qu’il donnera sur votre propre projet.
Bon à savoir : quand vous lisez « tel modèle réussit tant de tâches » dans une annonce, cherchez quel harnais a servi. Sans cette précision, le chiffre ne se compare pas à celui d’un autre outil.
Ce que ça change pour vous
Choisir un agent de code revient à choisir deux choses : un modèle et un outil. Les outils suivis par QUELLE IA n’acceptent pas tous les mêmes modèles :
Les outils de code suivis
- OpenCodeAnomaly87 modèles
- Droid (Factory)Factory56 modèles
- CursorAnysphere55 modèles
- Devin Desktop (ex-Windsurf)Cognition41 modèles
- JetBrains AI AssistantJetBrains38 modèles
- Warp37 modèles
- ZedZed Industries31 modèles
- Augment CodeAugment Code29 modèles
Nombre de modèles classés sur QUELLE IA que chaque outil propose, d'après sa propre liste, relevée au plus tard le 16 novembre 2026.
Quelques conséquences pratiques :
- Avant de conclure qu’un modèle est mauvais, essayez-le dans un autre outil sur la même tâche. L’écart peut venir des consignes ou de la boucle.
- Vous faites aussi partie du harnais. Le fichier de consignes du projet (CLAUDE.md, AGENTS.md, GEMINI.md), les procédures enregistrées en skills et les serveurs MCP branchés s’ajoutent à ce que l’outil envoie au modèle.
- Donnez à l’agent un moyen de vérifier son travail : des tests qu’il peut lancer, une commande qui démarre l’application. La boucle sert peu si le modèle n’a rien pour juger son résultat.
- Gardez ce fichier court. Anthropic conseille moins de 200 lignes pour CLAUDE.md : au-delà, il occupe la mémoire de travail du modèle et se trouve moins bien suivi.
Un fichier de consignes qui aide la boucle de l’agent tient en quelques lignes. Il dit comment lancer le projet et comment vérifier le travail :
# AGENTS.md
- Installer : npm install
- Lancer : npm run dev, puis ouvrir http://localhost:4321
- Vérifier avant de dire « fini » : npm test doit passer.
- Une seule fonction à la fois ; enregistrer dans Git à chaque étape réussie.
Le classement Code compare les modèles, la page des outils compare les programmes. Les deux se lisent ensemble.
Pour aller plus loin
- Le même modèle selon l'outil
- Outils de code et agents
- Classement Code des modèles de langage
- Classement Agents des modèles de langage
- Installer son premier agent de code : Claude Code, Codex, VibeNiveau Amateur 20 min
- Brancher Ollama dans un agent de codeNiveau Expert 25 min
- Skills, plugins, extensions : enrichir son agent de codeNiveau Expert 18 min
- Claude Code en pratique : terminal, IDE, bureau et webNiveau Amateur 14 min
- Coder avec Gemini : Antigravity, Canvas, et la fin de JulesNiveau Amateur 12 min
- Codex, l'agent de code d'OpenAI : terminal, éditeur, appli, nuageNiveau Amateur 15 min
Sur mini lab AI, un guide du même auteur reprend ce sujet pour monter son atelier d'IA à la maison.
Sources
- anthropic.com, lue le
- anthropic.com, lue le
- tbench.ai, lue le
- code.claude.com, lue le