Une API d’IA se paie au jeton : ceux que vous envoyez (la consigne, les documents, l’historique, la question) et ceux que le modèle écrit. Le guide sur les jetons et les prix explique ce décompte. Celui-ci part d’un constat : la plupart des applications envoient des milliers de fois le même début de requête. Quatre leviers réduisent la facture, et ils se cumulent.
Comment ça marche
Quand le modèle lit une requête, il calcule un état intermédiaire pour chaque jeton (le cache KV, déjà rencontré dans le guide sur les serveurs d’inférence). Si deux requêtes commencent par exactement le même texte, ce calcul peut se garder et se réutiliser : c’est la mise en cache des consignes (prompt caching). Le fournisseur facture alors les jetons relus bien moins cher que des jetons neufs.
Tout repose sur le préfixe : le cache ne sert que si le début de la requête est identique au caractère près, outils et consigne système compris. Rangez donc votre requête du plus stable au plus variable : outils, consigne, documents, historique, puis la question.
Le cache chez Anthropic
La documentation d’Anthropic, lue le 17 novembre 2026, fixe ces règles :
- Activation. Un champ
cache_controlau premier niveau de la requête suffit (mise en cache automatique) ; on peut aussi en poser jusqu’à quatre sur des blocs précis. - Durée. Cinq minutes par défaut, prolongées gratuitement à chaque lecture ; une heure en option.
- Prix. L’écriture coûte 1,25 fois le prix d’entrée pour cinq minutes, 2 fois pour une heure ; la lecture 0,1 fois. Plusieurs modèles récents lisent encore moins cher : 0,05 fois pour Claude Opus 5.5 et Claude Sonnet 5.5, 0,025 fois pour les Claude Fable 5.1 et 5.2.
- Seuil. En dessous d’un minimum qui dépend du modèle (de 512 à 4 096 jetons selon les modèles), rien n’est mis en cache, sans message d’erreur.
- Contrôle. La réponse indique
cache_creation_input_tokens(jetons écrits) etcache_read_input_tokens(jetons relus). Si les deux valent zéro, rien n’a été mis en cache.
# pip install anthropic ; variable ANTHROPIC_API_KEY
import anthropic

client = anthropic.Anthropic()
MANUEL = open("manuel.md", encoding="utf-8").read()   # le long texte commun à toutes les questions

def demande(question):
    reponse = client.messages.create(
        model="claude-sonnet-5-5",
        max_tokens=500,
        cache_control={"type": "ephemeral"},          # mise en cache automatique du préfixe
        system=[{"type": "text", "text": "Tu réponds d'après ce manuel, en citant la section.\n\n" + MANUEL}],
        messages=[{"role": "user", "content": question}],
    )
    u = reponse.usage
    print(f"écrits {u.cache_creation_input_tokens}, relus {u.cache_read_input_tokens}, neufs {u.input_tokens}")
    return reponse.content[0].text

demande("Comment réinitialiser l'appareil ?")   # premier appel : écriture du cache
demande("Quelle est la garantie ?")             # appel suivant, moins de cinq minutes après : lecture
Le cache chez OpenAI
Chez OpenAI, la mise en cache est active par défaut sur les modèles compatibles, sans rien ajouter à la requête. Sa documentation, lue le même jour, distingue les générations :
- à partir de GPT-5.6, un préfixe de 1 024 jetons visibles au moins, une lecture à 0,1 fois le prix d’entrée (0,05 fois pour certains modèles GPT-6.1 et GPT-6.2), une écriture à 1,25 fois pour une durée de 30 minutes ou 2,5 fois pour 12 heures ;
- avant GPT-5.6, aucun supplément à l’écriture, un tarif de lecture propre à chaque modèle, et un paramètre
prompt_cache_keyconseillé pour regrouper les requêtes qui partagent un préfixe.
Le champ cached_tokens de la réponse donne le nombre de jetons relus.
Le traitement par lots
Quand la réponse peut attendre, envoyez les requêtes en lot. Anthropic et OpenAI facturent alors moitié prix, entrée et sortie comprises, avec une réponse sous 24 heures au plus. Chez Anthropic, la plupart des lots finissent en moins d’une heure, un lot compte jusqu’à 100 000 requêtes ou 256 Mo, et ses résultats restent disponibles 29 jours. Les deux remises (cache et lots) s’y cumulent, mais les lectures du cache n’y sont pas garanties, les requêtes étant traitées en parallèle.
# Anthropic : créer un lot, attendre, lire les résultats
import time
import anthropic
from anthropic.types.message_create_params import MessageCreateParamsNonStreaming
from anthropic.types.messages.batch_create_params import Request

client = anthropic.Anthropic()
questions = ["Résume ce ticket : …", "Classe ce ticket : …"]
lot = client.messages.batches.create(requests=[
    Request(custom_id=f"q{i}", params=MessageCreateParamsNonStreaming(
        model="claude-sonnet-5-5", max_tokens=300, messages=[{"role": "user", "content": q}]))
    for i, q in enumerate(questions)
])
while client.messages.batches.retrieve(lot.id).processing_status != "ended":
    time.sleep(60)
for r in client.messages.batches.results(lot.id):
    if r.result.type == "succeeded":
        print(r.custom_id, r.result.message.content[0].text)
Chez OpenAI, le lot part d’un fichier JSONL, une requête par ligne, envoyé puis lancé :
# OpenAI : fichier JSONL, une ligne par requête, par exemple
# {"custom_id": "q0", "method": "POST", "url": "/v1/responses", "body": {"model": "gpt-6-luna", "input": "Classe ce ticket : …"}}
from openai import OpenAI

client = OpenAI()
fichier = client.files.create(file=open("lot.jsonl", "rb"), purpose="batch")
lot = client.batches.create(input_file_id=fichier.id, endpoint="/v1/responses", completion_window="24h")
print(lot.id, lot.status)
Aucun des exemples d’appel de ce guide n’a été exécuté sur le mini-PC de QUELLE IA : ils demandent une clé d’API payante. Ils suivent les documentations d’Anthropic et d’OpenAI lues le 17 novembre 2026.
Faire le calcul avant de coder
Ce petit calculateur, en Python pur, estime la facture de 1 000 questions posées sur un même manuel de 20 000 jetons. Les prix d’exemple sont ceux de Claude Sonnet 5.5 sur la page d’Anthropic le 17 novembre 2026 : 2 dollars le million de jetons en entrée, 10 en sortie, lecture du cache à 0,05 fois. Remplacez-les par ceux de votre modèle.
"""Estimer la facture d'un traitement répété : sans cache, avec cache, avec cache et par lots.
Les prix se passent en dollars par million de jetons ; les multiplicateurs sont ceux d'Anthropic (à vérifier pour votre modèle)."""

def facture(n, prefixe, question, reponse, entree, sortie, ecriture=1.25, lecture=0.1, lots=1.0):
    """n requêtes qui partagent un préfixe ; renvoie le coût en dollars."""
    m = 1e6
    if ecriture is None:                       # pas de cache : tout le préfixe au prix d'entrée
        cout_prefixe = n * prefixe * entree / m
    else:                                      # une écriture, puis des lectures (requêtes dans la durée du cache)
        cout_prefixe = (prefixe * entree * ecriture + (n - 1) * prefixe * entree * lecture) / m
    cout = cout_prefixe + n * question * entree / m + n * reponse * sortie / m
    return cout * lots

# 1 000 questions sur un même manuel de 20 000 jetons, 200 jetons de question, 300 de réponse.
# Prix d'exemple : 2 $ en entrée et 10 $ en sortie par million de jetons, lecture du cache à 0,05 fois.
cas = dict(n=1000, prefixe=20_000, question=200, reponse=300, entree=2.0, sortie=10.0)
print(f"sans cache          : {facture(**cas, ecriture=None):6.2f} $")
print(f"avec cache          : {facture(**cas, lecture=0.05):6.2f} $")
print(f"avec cache et lots  : {facture(**cas, lecture=0.05, lots=0.5):6.2f} $")
print(f"lots sans cache     : {facture(**cas, ecriture=None, lots=0.5):6.2f} $")
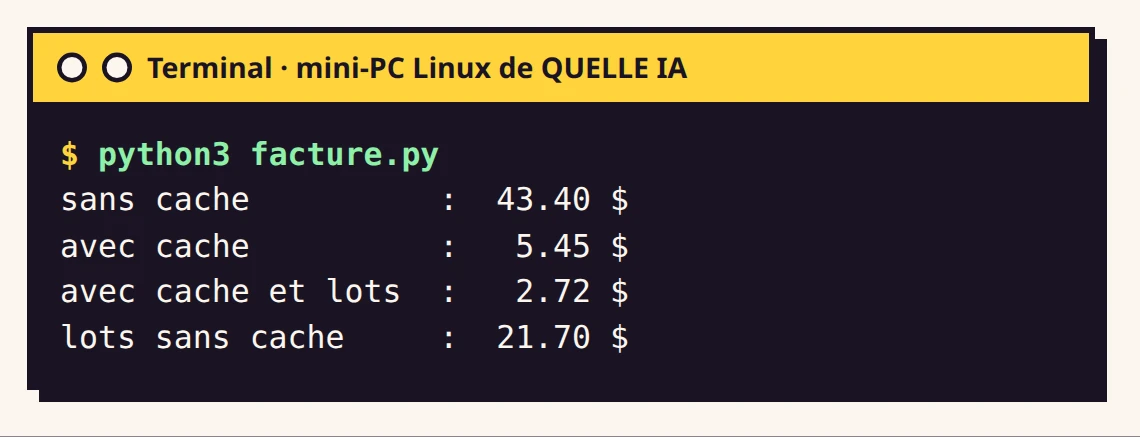
Le cache divise ici la facture par huit, parce que le manuel pèse cent fois plus que chaque question. Le calcul suppose que les requêtes se suivent à moins de cinq minutes d’intervalle ; espacées davantage, chacune réécrit le cache, et la durée d’une heure devient plus rentable. La ligne « avec cache et lots » est un plancher, puisque les lectures du cache ne sont pas garanties dans un lot.
Les deux autres leviers
Le modèle. Les écarts de prix entre modèles dépassent souvent ceux que procure le cache. Un petit modèle bien guidé suffit pour classer, extraire ou résumer ; gardez le grand pour ce qui l’exige, et vérifiez-le sur votre propre banc d’essai. Les jetons de sortie coûtent cher : cinq fois le prix d’entrée pour les modèles d’Anthropic cités plus haut. Une consigne qui demande des réponses courtes et un max_tokens raisonnable comptent donc autant que le choix du modèle.
L’effort. Les modèles qui réfléchissent avant de répondre facturent cette réflexion en jetons de sortie. Chez Anthropic, le paramètre effort (de low à max) la règle : medium est le réglage par défaut de Claude Opus 5.5 et Claude Haiku 5.5, high celui des autres. Baisser l’effort sur une tâche simple réduit la facture ; le guide sur l’effort détaille quand le faire.
Pour un usage personnel plutôt qu’une application, un abonnement revient souvent moins cher que l’API :
Les formules grand public, en France
- ChatGPTOpenAIFree : Gratuit · Go : 8 € · Plus : 23 € · Pro : dès 103 €
- ClaudeAnthropicFree : Gratuit · Pro : 20 $ · Max : 100 $ · Ultra : 200 $
- GeminiGoogleSans frais : Gratuit · Google AI Plus : 4,99 € · Google AI Pro : 21,99 € · Google AI Ultra : dès 99,99 €
- Vibe (ex-Le Chat)Mistral AIFree : Gratuit · Pro : 17,99 €
- Microsoft CopilotMicrosoftCopilot gratuit : Gratuit · Microsoft 365 Personnel : 10 € · Microsoft 365 Famille : 13 € · Microsoft 365 Premium : 22 € · Microsoft 365 Professionnel : 110 €
- PerplexityPerplexityGratuit
- GrokxAIGratuit · Plus : 8 € · Premium : 31 € · Super : 105 € · Ultra : 210 €
- Meta AIMetaGratuit · Meta One Core : 6,99 € · Meta One Premium : 20,99 €
- DeepSeekDeepSeekGratuit
- Qwen ChatAlibabaGratuit
- KimiMoonshot AIAdagio : Gratuit · Plus : 19 $ · Pro : 39 $ · Max : 99 $ · Ultra : 199 $
- LumoProtonGratuit · Lumo AI Plus : 12,99 €
Prix par mois affichés en France sur la page officielle de chaque assistant, relevés au plus tard le 17 novembre 2026. Vérifiez avant de payer.
Les pièges
- Un préfixe qui bouge. Une date, un horodatage ou un identifiant de session placé en tête de la consigne change le préfixe à chaque requête : le cache ne sert jamais, et chez Anthropic on paie même une écriture à chaque fois. Mettez ces éléments variables à la fin.
- Un préfixe trop court. Sous le seuil du modèle, rien n’est mis en cache, sans erreur. Vérifiez les champs de la réponse.
- Changer d’outils ou de schéma. Les outils et le schéma de sortie font partie du préfixe : les modifier invalide le cache.
- Un RAG quand tout tiendrait dans la requête. Anthropic rappelle qu’en dessous d’environ 200 000 jetons, on peut envoyer toute la base à chaque question et laisser le cache faire baisser le prix. La chaîne est plus simple, et aucune recherche ne risque de rater le bon passage.
- Oublier le local. Pour de gros volumes de tâches simples, un modèle local ne coûte que l’électricité et la machine. llama-server, par exemple, garde aussi en cache le début commun des requêtes (option
cache_prompt, active par défaut).
Pour aller plus loin
- Jetons, prix au million et vrai coût d'une tâcheNiveau Amateur 5 min
- Quel effort de réflexion choisir pour une IA, et quandNiveau Amateur 10 min
- RAG : donner ses documents à un modèle, pas à pasNiveau Nerd 25 min
- Servir un modèle : llama.cpp, vLLM, SGLang ou OllamaNiveau Nerd 20 min
- Claude Code en pratique : terminal, IDE, bureau et webNiveau Amateur 14 min
- Coder avec Gemini : Antigravity, Canvas, et la fin de JulesNiveau Amateur 12 min
- Codex, l'agent de code d'OpenAI : terminal, éditeur, appli, nuageNiveau Amateur 15 min
Pour monter son atelier d'IA à la maison, mini lab AI, du même auteur, va plus loin.
Sources
- platform.claude.com, lue le
- platform.claude.com, lue le
- platform.claude.com, lue le
- platform.claude.com, lue le
- developers.openai.com, lue le
- developers.openai.com, lue le
- anthropic.com, lue le
- github.com, lue le