Ollama est fait pour une personne devant sa machine : il télécharge un modèle, le charge et répond. Dès qu’un même modèle doit répondre à une équipe, à un site web ou à un agent qui lance des dizaines de requêtes en parallèle, un serveur d’inférence (llama.cpp en mode serveur, vLLM, SGLang) fait bien mieux. Il fait passer beaucoup plus de réponses par seconde sur la même carte graphique, sans accélérer une réponse isolée.
Quand changer d’outil
Restez sur Ollama si :
- une personne, ou quelques scripts à tour de rôle, interrogent le modèle ;
- vous changez souvent de modèle et voulez une commande pour tout faire.
Passez à un serveur d’inférence si :
- plusieurs utilisateurs ou programmes envoient des requêtes en même temps et attendent leur tour ;
- vous traitez de gros volumes en lot (classer 100 000 documents, résumer une archive) ;
- vos requêtes partagent un long début commun, comme la même consigne système ou le même document ;
- vous avez besoin de métriques, de plusieurs clés d’API ou d’un réglage fin de la mémoire.
Comment ça marche
Pour écrire chaque jeton, le modèle relit ses poids en mémoire (le guide sur la vitesse locale détaille ce coût). Avec une seule requête, la carte graphique passe surtout son temps à attendre la mémoire. Si l’on fait avancer dix requêtes d’un même pas, les poids lus une fois servent aux dix : c’est le traitement par lots.
Le lot continu (continuous batching) va plus loin. Une requête qui se termine libère sa place aussitôt, et une nouvelle entre au pas suivant, sans attendre que tout le lot ait fini. llama-server l’active par défaut, et vLLM le cite parmi ses fonctions de base.
Reste la mémoire du cache KV, où le modèle garde le calcul de tout ce qu’il a déjà lu pour chaque requête. Elle grossit avec la longueur des conversations et leur nombre. Ollama le dit dans sa FAQ : la mémoire nécessaire croît avec le produit du nombre de requêtes parallèles par la longueur de contexte. vLLM a été conçu autour de ce problème : son article de 2023 présente PagedAttention, qui range ce cache par pages comme la mémoire virtuelle d’un système d’exploitation, et annonce un débit multiplié par 2 à 4 face aux serveurs de l’époque, à latence égale.
Le cache de préfixe évite enfin de recalculer un début identique : la consigne système partagée par toutes les requêtes n’est lue qu’une fois. vLLM l’identifie par des empreintes de blocs, SGLang par un arbre de préfixes (RadixAttention, présenté dans son article de 2023), llama-server par l’option cache_prompt, active par défaut.
| Outil | Pour qui | Points forts | Systèmes |
|---|---|---|---|
| Ollama | une personne, un poste | simplicité, catalogue de modèles | Mac, Windows, Linux |
| llama-server (llama.cpp) | un petit serveur, une équipe | fichiers GGUF, processeur ou carte graphique, peu de dépendances | Mac, Windows, Linux |
| vLLM | un service à fort trafic | débit, PagedAttention, nombreuses cartes | Linux (Mac par vLLM-Metal) |
| SGLang | un service à fort trafic, des agents | RadixAttention, sorties structurées rapides | Linux, surtout avec carte NVIDIA |
Mise en œuvre
Tous parlent la même langue : une API compatible avec celle d’OpenAI. Le code d’un client ne change que par l’adresse et le nom du modèle.
Ollama, réglé pour plusieurs requêtes
Avant de changer d’outil, réglez Ollama. Sa FAQ donne trois variables d’environnement, à poser avant de lancer le serveur :
OLLAMA_NUM_PARALLEL: nombre de requêtes traitées en même temps par un modèle (1 par défaut) ;OLLAMA_MAX_QUEUE: nombre de requêtes mises en attente avant de répondre « 503 » (512 par défaut) ;OLLAMA_MAX_LOADED_MODELS: nombre de modèles chargés en même temps.
OLLAMA_NUM_PARALLEL=4 OLLAMA_CONTEXT_LENGTH=8192 ollama serve
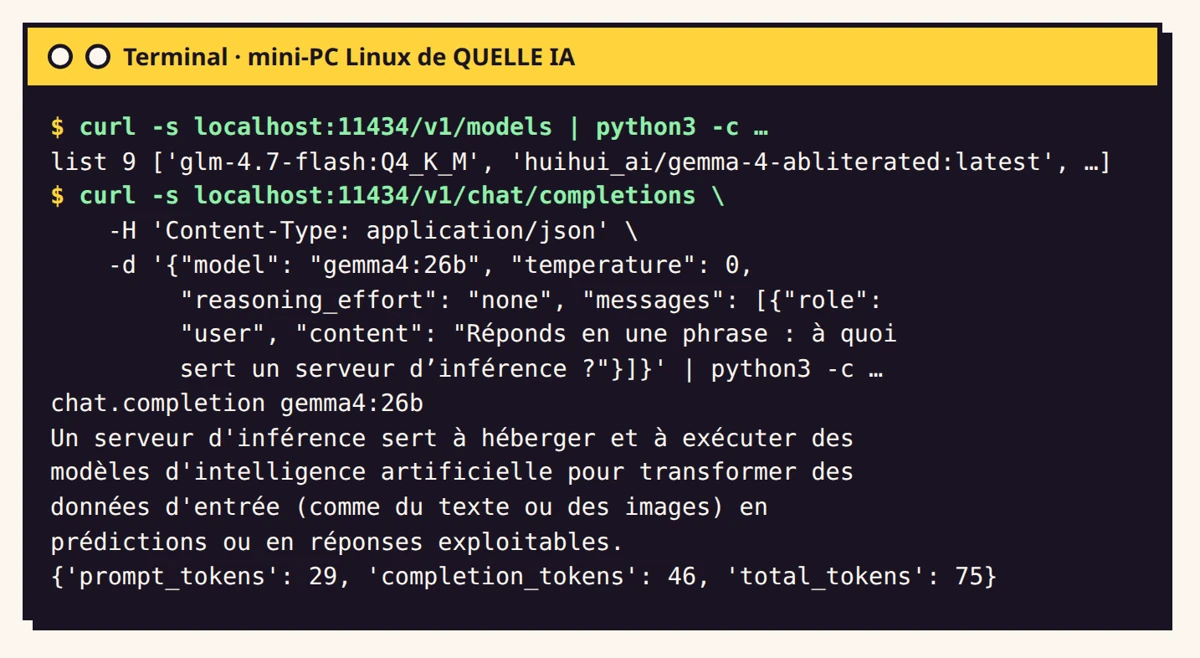
Ollama expose déjà une route compatible OpenAI sous /v1. Sur le mini-PC de QUELLE IA :
llama-server (llama.cpp)
- Installez llama.cpp (paquet de votre système ou binaire publié sur le dépôt), puis lancez le serveur sur un modèle GGUF, ou directement depuis Hugging Face avec
-hf:
llama-server -hf ggml-org/gemma-3-4b-it-GGUF \
  --host 127.0.0.1 --port 8080 \
  -c 16384 -np 4 \
  --api-key "$(openssl rand -hex 16)" --metrics
-
-np 4ouvre quatre emplacements (slots) traités en parallèle,-cfixe la longueur de contexte,--api-keyexige une clé,--metricsouvre une route de métriques au format Prometheus. Le lot continu est actif par défaut. -
Testez la route compatible OpenAI :
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Authorization: Bearer VOTRE_CLE" -H "Content-Type: application/json" \
  -d '{"messages": [{"role": "user", "content": "Bonjour"}]}'
llama-server sait aussi servir des plongements (--embedding, route /v1/embeddings) et réordonner des passages pour un RAG (--reranking, route /v1/rerank).
vLLM
vLLM s’installe sous Linux avec une carte NVIDIA, AMD ou Intel, ou sur une puce Apple par vLLM-Metal. Sa documentation recommande uv :
uv venv --python 3.12 --seed
source .venv/bin/activate
uv pip install vllm --torch-backend=auto
vllm serve Qwen/Qwen2.5-1.5B-Instruct --api-key "$(openssl rand -hex 16)"
Le serveur écoute sur http://localhost:8000 par défaut et sert un modèle à la fois. Le cache de préfixe automatique se commande par --enable-prefix-caching, et --no-enable-prefix-caching le coupe.
SGLang
SGLang vise Linux avec une carte NVIDIA compatible CUDA 13 dans son démarrage rapide, et prend aussi en charge des cartes AMD, Intel et des TPU de Google :
uv venv --python 3.12
source .venv/bin/activate
uv pip install --prerelease=allow sglang
sglang serve Qwen/Qwen3-0.6B --host 0.0.0.0 --port 30000
Attendez le message The server is fired up and ready to roll!, puis interrogez http://localhost:30000/v1/chat/completions.
Un client unique pour tous
Ce client en Python, avec la bibliothèque openai, marche contre les quatre serveurs : changez l’adresse, la clé et le nom du modèle.
# pip install openai
from openai import OpenAI

client = OpenAI(base_url="http://localhost:11434/v1", api_key="ollama")  # Ollama ignore la clé
# client = OpenAI(base_url="http://127.0.0.1:8080/v1", api_key="VOTRE_CLE")  # llama-server
# client = OpenAI(base_url="http://localhost:8000/v1", api_key="VOTRE_CLE")  # vLLM
# client = OpenAI(base_url="http://localhost:30000/v1", api_key="EMPTY")     # SGLang

reponse = client.chat.completions.create(
    model="gemma4:26b",
    messages=[{"role": "user", "content": "Réponds en une phrase : à quoi sert un serveur d'inférence ?"}],
    temperature=0,
)
print(reponse.choices[0].message.content)
print(reponse.usage)
Seule la commande curl de la capture a été exécutée sur le mini-PC de QUELLE IA. llama-server, vLLM et SGLang n’y sont pas installés : leurs commandes suivent leurs documentations lues le 17 novembre 2026.
Mesurer le débit
Le chiffre qui compte change avec l’usage. Pour une personne, c’est la vitesse d’une réponse (jetons par seconde) et le délai avant le premier jeton. Pour un service, c’est le débit total à 1, 4, 16 et 64 requêtes simultanées, avec le délai qui l’accompagne. Mesurez les deux sur vos propres demandes, avec la même longueur de réponse : un serveur qui double son débit total en doublant le délai de chacun n’arrange pas forcément vos utilisateurs.
Les pièges
- Un serveur ouvert sans clé. Par défaut, ces serveurs n’exigent aucune authentification. Écoutez sur
127.0.0.1, ou posez une clé (--api-keypour llama-server et vLLM) et un serveur mandataire HTTPS devant. - Des réglages d’échantillonnage imposés en silence. vLLM applique le fichier
generation_config.jsondu dépôt du modèle, qui peut changer la température par défaut. L’option--generation-config vllmrend la main à vos réglages. - Des réponses moins reproductibles. La documentation de llama.cpp prévient qu’avec le cache de la demande actif, les calculs ne sont pas garantis identiques au bit près selon la taille des lots : à température nulle, deux appels peuvent différer.
- La mémoire du cache. Plus de requêtes parallèles et des contextes plus longs demandent plus de mémoire. Quand vLLM manque de place, il interrompt des requêtes pour les recalculer plus tard, et ses journaux le signalent : réduisez alors
max_num_seqsou la longueur de contexte. - Un modèle qui ne sait pas appeler d’outils. llama-server ne gère l’appel d’outils qu’avec le moteur de gabarits Jinja (
--jinja, actif par défaut) et parfois un gabarit de discussion adapté.
Coût et matériel
Le serveur ne crée pas de mémoire : un modèle qui ne tient pas sur votre machine avec Ollama ne tiendra pas mieux ailleurs, et le cache KV des requêtes parallèles s’ajoute aux poids. Les pages machines de QUELLE IA donnent la mémoire utile de chaque configuration et les modèles qui y tiennent. Un service à fort trafic se joue surtout sur des cartes graphiques NVIDIA ou AMD, cibles premières de vLLM et SGLang ; sur un Mac ou un mini-PC à mémoire unifiée, llama-server reste le choix le plus simple.
Pour aller plus loin
- La vitesse d'un modèle local : débit mémoire et expertsNiveau Nerd 15 min
- Quantification : Q4, Q8, ce qu'on gagne et ce qu'on perdNiveau Expert 14 min
- Réduire la facture d'une API d'IA : cache, lots, modèle, effortNiveau Expert 20 min
- Construire un agent : la boucle, les outils et les garde-fousNiveau Nerd 30 min
- Faire tourner une IA sur son ordinateur avec OllamaNiveau Débutant 15 min
- LM Studio, l'IA locale sans ouvrir de terminalNiveau Débutant 12 min
- Les modèles Mistral en local avec Ollama ou LM StudioNiveau Amateur 12 min
Pour monter son atelier d'IA à la maison, mini lab AI, du même auteur, va plus loin.
Sources
- docs.ollama.com, lue le
- docs.ollama.com, lue le
- github.com, lue le
- github.com, lue le
- docs.vllm.ai, lue le
- docs.vllm.ai, lue le
- docs.vllm.ai, lue le
- docs.vllm.ai, lue le
- arxiv.org, lue le
- github.com, lue le
- docs.sglang.io, lue le
- arxiv.org, lue le