Un modèle de langage ne connaît ni vos contrats, ni vos notes internes, ni la documentation de votre logiciel. Le RAG (retrieval-augmented generation, génération augmentée par la recherche) règle ce problème sans toucher au modèle : avant chaque réponse, un programme cherche dans vos documents les passages qui parlent de la question, puis les colle dans la demande. Le modèle répond en s’appuyant sur ces extraits, et peut les citer.
L’idée vient d’un article de chercheurs de Facebook AI publié en 2020 (Lewis et ses coauteurs), qui associait un modèle de génération à un index de Wikipédia interrogé par un moteur de recherche neuronal. Le principe n’a pas bougé depuis.
À quoi ça sert
- Interroger une documentation interne : règlement, procédures, fiches produits, tickets de support. La réponse cite le document d’où elle vient, ce qui permet de la vérifier.
- Garder ses données chez soi : avec un modèle local, ni les documents ni les questions ne quittent la machine.
- Suivre des documents qui changent : on réindexe un fichier modifié en quelques secondes, alors qu’un modèle affiné devrait être réentraîné.
Bon à savoir : un RAG n’est pas toujours nécessaire. Anthropic rappelle qu’en dessous d’environ 200 000 jetons (quelques centaines de pages), on peut placer toute la base dans la demande, et que la mise en cache des consignes rend cette méthode rapide et peu chère. Le guide sur le cache et les coûts de l’API détaille ce calcul.
Comment ça marche
La chaîne se coupe en deux temps.
L’indexation, faite une fois puis à chaque changement de document :
- Le découpage. Chaque document est coupé en morceaux (chunks). Anthropic conseille des morceaux de quelques centaines de jetons au plus. Trop gros, un morceau mélange plusieurs sujets ; trop petit, il perd son contexte.
- Les plongements. Un modèle spécialisé transforme chaque morceau en vecteur, une liste de quelques centaines de nombres qui résume son sens. Deux textes proches par le sens donnent des vecteurs proches. Le guide sur les plongements explique ce calcul en détail.
- L’index. On range les morceaux et leurs vecteurs : un simple fichier JSON suffit pour quelques milliers de morceaux, une base vectorielle devient utile au-delà.
La réponse, refaite à chaque question :
- La recherche. La question passe par le même modèle de plongement. On calcule sa proximité (le cosinus) avec chaque vecteur de l’index et on garde les k plus proches.
- Le réordonnancement. Un second modèle relit chaque paire « question, passage » et la note. Il est plus lent que la recherche vectorielle, mais bien plus fin, d’où son usage sur une courte liste.
- La génération. Le modèle de langage reçoit une consigne, les meilleurs extraits numérotés et la question. On lui demande de répondre à partir des seuls extraits et de les citer.
Anthropic a mesuré l’effet de chaque brique sur ses propres jeux de test : en ajoutant à la recherche vectorielle une recherche par mots-clés (BM25), un contexte ajouté à chaque morceau, puis un réordonnancement, la part des recherches qui ratent le bon passage dans les 20 premiers résultats est passée de 5,7 % à 1,9 %.
Mise en œuvre pas à pas
L’exemple tourne sur n’importe quel ordinateur où Ollama est installé, sans aucune bibliothèque Python à ajouter. Il interroge quatre petites notes internes d’une entreprise fictive (télétravail, notes de frais, congés, matériel).
- Téléchargez un modèle de plongement et un modèle de discussion. Prenez le second parmi ceux qui tiennent dans votre mémoire (liste en fin de guide) ; l’exemple utilise
gemma4:26b.
ollama pull nomic-embed-text
ollama pull gemma4:26b
- Créez un dossier
docs/avec vos fichiers Markdown. Le script attend un titre en première ligne, puis des paragraphes séparés par une ligne vide. Exemple,docs/frais.md:
# Notes de frais

Les notes de frais se saisissent dans l'application Dépenses au plus tard 30 jours après la dépense.

Un repas d'affaires est remboursé jusqu'à 35 euros par personne, sur présentation du justificatif.

Les trajets en train se réservent en seconde classe, sauf pour un trajet de plus de quatre heures.
- Enregistrez le script sous
rag.py, à côté du dossierdocs/:
"""RAG minimal avec Ollama : découpage, plongements, recherche, réordonnancement, réponse.
Aucune dépendance : Python 3.10 ou plus et un serveur Ollama sur http://localhost:11434."""
import json, math, sys, urllib.request
from pathlib import Path

OLLAMA = "http://localhost:11434"
EMBED = "nomic-embed-text"      # modèle de plongements (ollama pull nomic-embed-text)
LLM = "gemma4:26b"              # modèle qui répond (n'importe quel modèle de discussion)
INDEX = Path("index.json")


def appel(route, donnees):
    req = urllib.request.Request(f"{OLLAMA}{route}", data=json.dumps(donnees).encode(),
                                 headers={"Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=300) as r:
        return json.load(r)


def plonge(textes, prefixe):
    # nomic-embed-text attend un préfixe de tâche : search_document pour les documents, search_query pour la question.
    r = appel("/api/embed", {"model": EMBED, "input": [f"{prefixe}: {t}" for t in textes]})
    return r["embeddings"]


def decoupe(fichier):
    # Un morceau par paragraphe, précédé du titre du document pour garder le contexte.
    lignes = fichier.read_text(encoding="utf-8").strip().split("\n\n")
    titre = lignes[0].lstrip("# ").strip()
    return [{"source": fichier.name, "texte": f"{titre}. {p.strip()}"} for p in lignes[1:]]


def indexe(dossier):
    morceaux = [m for f in sorted(Path(dossier).glob("*.md")) for m in decoupe(f)]
    vecteurs = plonge([m["texte"] for m in morceaux], "search_document")
    for m, v in zip(morceaux, vecteurs):
        m["vecteur"] = v
    INDEX.write_text(json.dumps(morceaux), encoding="utf-8")
    print(f"{len(morceaux)} morceaux indexés")


def cosinus(a, b):
    # /api/embed rend des vecteurs de longueur 1 : le produit scalaire suffit, la division est là par prudence.
    return sum(x * y for x, y in zip(a, b)) / (math.sqrt(sum(x * x for x in a)) * math.sqrt(sum(y * y for y in b)))


def reordonne(question, candidats):
    # Le modèle note chaque passage de 0 à 10 ; la réponse est contrainte par un schéma JSON.
    schema = {"type": "object", "properties": {"note": {"type": "integer"}}, "required": ["note"]}
    for c in candidats:
        r = appel("/api/chat", {"model": LLM, "stream": False, "format": schema, "think": False,
                                "options": {"temperature": 0},
                                "messages": [{"role": "user", "content":
                                    f"Question : {question}\nPassage : {c['texte']}\n"
                                    "Note de 0 à 10 l'utilité du passage pour répondre à la question."}]})
        c["note"] = json.loads(r["message"]["content"])["note"]
    return sorted(candidats, key=lambda c: (c["note"], c["score"]), reverse=True)


def demande(question, k=4, garde=2):
    morceaux = json.loads(INDEX.read_text(encoding="utf-8"))
    q = plonge([question], "search_query")[0]
    for m in morceaux:
        m["score"] = cosinus(q, m["vecteur"])
    candidats = sorted(morceaux, key=lambda m: m["score"], reverse=True)[:k]
    print("Recherche vectorielle :")
    for c in candidats:
        print(f"  {c['score']:.3f}  {c['source']:<15} {c['texte'][:52]}…")
    retenus = reordonne(question, candidats)[:garde]
    print("Après réordonnancement :", ", ".join(f"{c['source']} ({c['note']}/10)" for c in retenus))
    contexte = "\n".join(f"[{i + 1}] ({c['source']}) {c['texte']}" for i, c in enumerate(retenus))
    r = appel("/api/chat", {"model": LLM, "stream": False, "think": False, "options": {"temperature": 0},
                            "messages": [
                                {"role": "system", "content": "Réponds en français, en une ou deux phrases, "
                                 "uniquement d'après les extraits fournis, et cite-les par leur numéro. "
                                 "Si les extraits ne contiennent pas la réponse, dis-le."},
                                {"role": "user", "content": f"Extraits :\n{contexte}\n\nQuestion : {question}"}]})
    print("Réponse :", r["message"]["content"].strip())


if __name__ == "__main__":
    if sys.argv[1] == "indexe":
        indexe(sys.argv[2])
    else:
        demande(" ".join(sys.argv[2:]))
- Indexez, puis posez une question :
python3 rag.py indexe docs
python3 rag.py demande "Combien me rembourse-t-on pour un déjeuner avec un client ?"
Voici ce que le script a affiché sur le mini-PC de QUELLE IA :
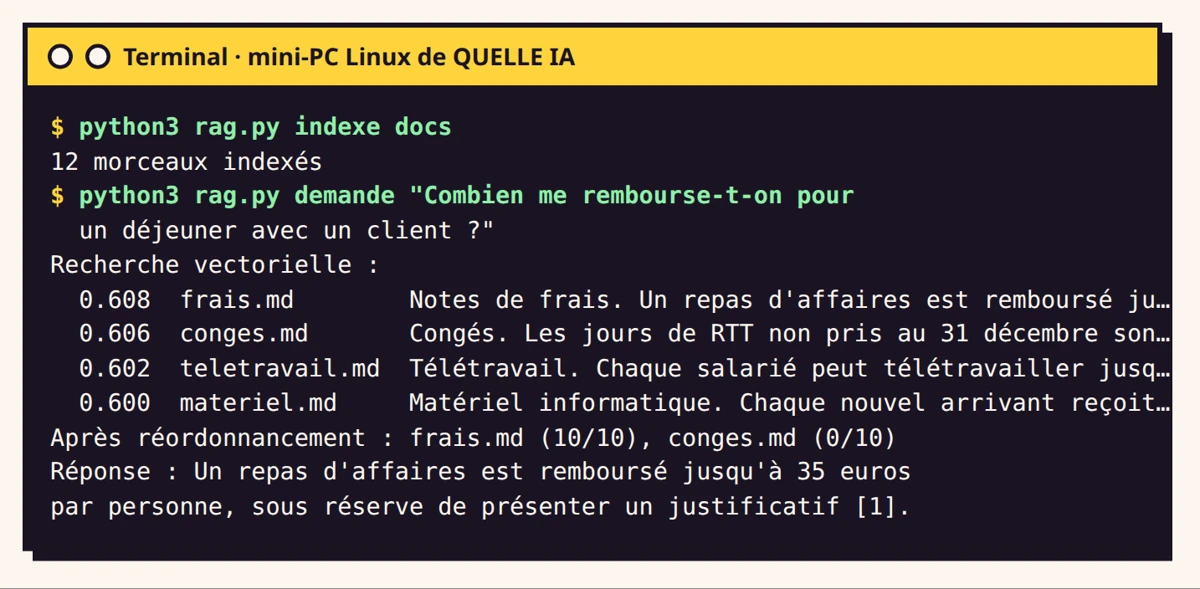
La sortie montre l’intérêt du réordonnancement. Les quatre scores de la recherche vectorielle tiennent entre 0,600 et 0,608 : le modèle de plongement distingue mal ces phrases en français, et la bonne note de frais ne passe en tête que de très peu. La notation par le modèle de langage tranche nettement (10 sur 10 contre 0), et la réponse cite le bon extrait.
Bon à savoir : le réordonnancement de l’exemple appelle le modèle de discussion une fois par passage, ce qui reste lent. Un vrai modèle de réordonnancement, comme bge-reranker-v2-m3, fait le même travail bien plus vite. Ollama n’a pas de route pour ces modèles ; le serveur de llama.cpp en propose une (
/v1/rerank), à lancer avec l’option--reranking.
Les pièges
- Un modèle de plongement anglais sur des textes français. La fiche de nomic-embed-text ne parle d’aucune autre langue que l’anglais, et la sortie ci-dessus montre des scores très serrés en français. Pour du français, essayez un modèle multilingue : embeddinggemma (Google, entraîné sur plus de 100 langues selon sa fiche Ollama) ou bge-m3 (plus de 100 langues). Mesurez sur vos propres questions avant de choisir.
- Changer de modèle de plongement sans tout réindexer. Les vecteurs de deux modèles ne se comparent pas. La documentation d’Ollama le rappelle : le même modèle sert à indexer et à interroger.
- Oublier les préfixes. nomic-embed-text exige
search_document:devant les documents etsearch_query:devant la question, d’après sa fiche. Sans eux, la recherche se dégrade sans message d’erreur. - Une fenêtre trop courte pour le modèle de plongement. Ollama sert nomic-embed-text avec une fenêtre de 2 048 jetons, alors que le modèle en accepte 8 192. Un morceau plus long est tronqué en silence (option
truncate, active par défaut). - Des morceaux sans contexte. Un paragraphe isolé (« Le plafond est de 35 euros ») ne dit plus de quoi il parle. Le script ajoute le titre du document à chaque morceau ; Anthropic va plus loin en faisant écrire par un modèle une phrase de contexte par morceau.
- Une réponse qui sort des extraits. Rien n’empêche le modèle d’inventer. La consigne qui l’oblige à citer et à dire « je ne sais pas » aide, et la citation permet au lecteur de vérifier.
Coût et matériel
En local, le coût se mesure en mémoire. nomic-embed-text pèse 274 Mo, presque rien à côté du modèle qui répond. Voici les mieux classés qui tiennent dans 32 Go.
Les meilleurs modèles pour une machine de 32 Go
- Qwen 3.8 27Ballégée à 4 bits, 18,6 Goscore 83,1
- Gemma 4 31B ITallégée à 4 bits, 21,4 Goscore 75,5
- Qwen3.6 27Ballégée à 4 bits, 19,2 Goscore 75,5
- Muse Glimmerallégée à 4 bits, 20,7 Goscore 73,9
- Gemma 4 26B A4Ballégée à 4 bits, 17,9 Goscore 73,1
Mémoire utile retenue : 30 Go, celle des machines suivies de 32 Go. Score IA de l'édition du 16 novembre 2026, version la plus complète qui tient.
Quel modèle sur ma machine →Les modèles qui tournent en local →
Avec une API payante, l’indexation coûte une fois le prix des plongements de tous vos documents, puis chaque question coûte le plongement de la question, plus les jetons d’entrée des extraits et de la consigne, plus la réponse. Le réordonnancement par un modèle de langage, tel que dans l’exemple, multiplie les appels : sur une API, préférez un modèle de réordonnancement dédié.
Pour aller plus loin
- Plongements (embeddings) : ranger des textes par leur sensNiveau Expert 15 min
- Fenêtre de contexte : ce que veut dire « 1 million de jetons »Niveau Débutant 2 min
- Réduire la facture d'une API d'IA : cache, lots, modèle, effortNiveau Expert 20 min
- Affiner un modèle : LoRA, QLoRA et quand ça vaut le coupNiveau Nerd 30 min
- Faire tourner une IA sur son ordinateur avec OllamaNiveau Débutant 15 min
- LM Studio, l'IA locale sans ouvrir de terminalNiveau Débutant 12 min
- Les modèles Mistral en local avec Ollama ou LM StudioNiveau Amateur 12 min
Pour monter son atelier d'IA à la maison, mini lab AI, du même auteur, va plus loin.
Sources
- arxiv.org, lue le
- anthropic.com, lue le
- docs.ollama.com, lue le
- docs.ollama.com, lue le
- docs.ollama.com, lue le
- huggingface.co, lue le
- ollama.com, lue le
- ollama.com, lue le
- ollama.com, lue le
- github.com, lue le