Demandez à un modèle « réponds en JSON » et il le fera presque toujours. Il suffit pourtant d’une virgule en trop, d’un champ oublié ou d’une phrase d’introduction avant l’accolade pour faire planter le programme qui lit la réponse. Les sorties structurées règlent ce problème à la source : on fournit un schéma JSON, et le serveur empêche le modèle d’écrire quoi que ce soit qui ne le respecte pas. Les appels d’outils reposent sur la même mécanique, appliquée aux arguments d’une fonction.
À quoi ça sert
- Extraire des données d’un courriel, d’une facture, d’une page web, vers une base ou un tableur.
- Classer des textes dans une liste fermée de catégories, sans valeur inventée.
- Piloter un programme : un agent qui appelle vos fonctions avec des arguments du bon type.
- Noter automatiquement, comme le juge du guide sur l’évaluation, qui rend un verdict lisible par le code.
Comment ça marche
Un modèle écrit un jeton à la fois en choisissant parmi des milliers de candidats. Le décodage contraint transforme le schéma JSON en une grammaire, puis, à chaque pas, écarte les jetons qui sortiraient de cette grammaire. Après "offre": ", si le schéma n’autorise que trois valeurs, seuls les jetons qui commencent l’une d’elles restent possibles. La réponse est valide par construction. Anthropic décrit exactement ce fonctionnement (constrained decoding, grammaire compilée à partir du schéma), et l’article de SGLang présente des automates compressés qui accélèrent ce décodage.
Trois niveaux existent, du plus faible au plus sûr :
| Niveau | Ce qui est garanti | Où |
|---|---|---|
| Consigne « réponds en JSON » | rien | partout |
| Mode JSON | un JSON valide, de forme libre | Ollama ("format": "json"), OpenAI (json_object) |
| Sortie structurée | un JSON conforme à votre schéma | Ollama, Anthropic, OpenAI, Gemini, llama-server, vLLM, SGLang |
Pour un appel d’outil, vous décrivez chaque fonction par un nom, une phrase et un schéma de paramètres. Le modèle choisit de répondre ou de renvoyer un appel en JSON ; votre code l’exécute et renvoie le résultat. Avec l’option strict (Anthropic, OpenAI), les arguments sont eux aussi produits par décodage contraint.
Pas à pas avec Ollama, en local
Ollama accepte un schéma JSON complet dans le champ format. Sa documentation conseille de rappeler aussi le schéma dans la consigne et de baisser la température à 0.
- Enregistrez ce script sous
extrait.py:
"""Sortie structurée avec Ollama : le champ format reçoit un schéma JSON, la réponse le respecte.
Aucune dépendance : Python 3.10 ou plus et un serveur Ollama."""
import json, urllib.request

SCHEMA = {
    "type": "object",
    "properties": {
        "nom": {"type": "string"},
        "email": {"type": "string"},
        "offre": {"type": "string", "enum": ["Découverte", "Pro", "Entreprise"]},
        "demo_demandee": {"type": "boolean"},
        "participants": {"type": "integer"},
    },
    "required": ["nom", "email", "offre", "demo_demandee", "participants"],
}
MAIL = ("Bonjour, je suis Claire Martin ([email protected]). Notre équipe de douze personnes "
        "s'intéresse à votre offre Entreprise. Pourriez-vous nous faire une démonstration mardi ?")

corps = {
    "model": "gemma4:26b", "stream": False, "think": False,
    "format": SCHEMA,                      # le schéma contraint la génération
    "options": {"temperature": 0},
    "messages": [{"role": "user", "content":
                  f"Extrais les informations de ce message. Schéma attendu : {json.dumps(SCHEMA, ensure_ascii=False)}\n\n{MAIL}"}],
}
req = urllib.request.Request("http://localhost:11434/api/chat", data=json.dumps(corps).encode(),
                             headers={"Content-Type": "application/json"})
with urllib.request.urlopen(req, timeout=600) as r:
    texte = json.load(r)["message"]["content"]
fiche = json.loads(texte)                  # ne lève pas d'erreur : le JSON est valide
print(json.dumps(fiche, ensure_ascii=False, indent=2))
assert isinstance(fiche["participants"], int) and fiche["offre"] in SCHEMA["properties"]["offre"]["enum"]
print("Schéma respecté")
- Lancez-le :
python3 extrait.py
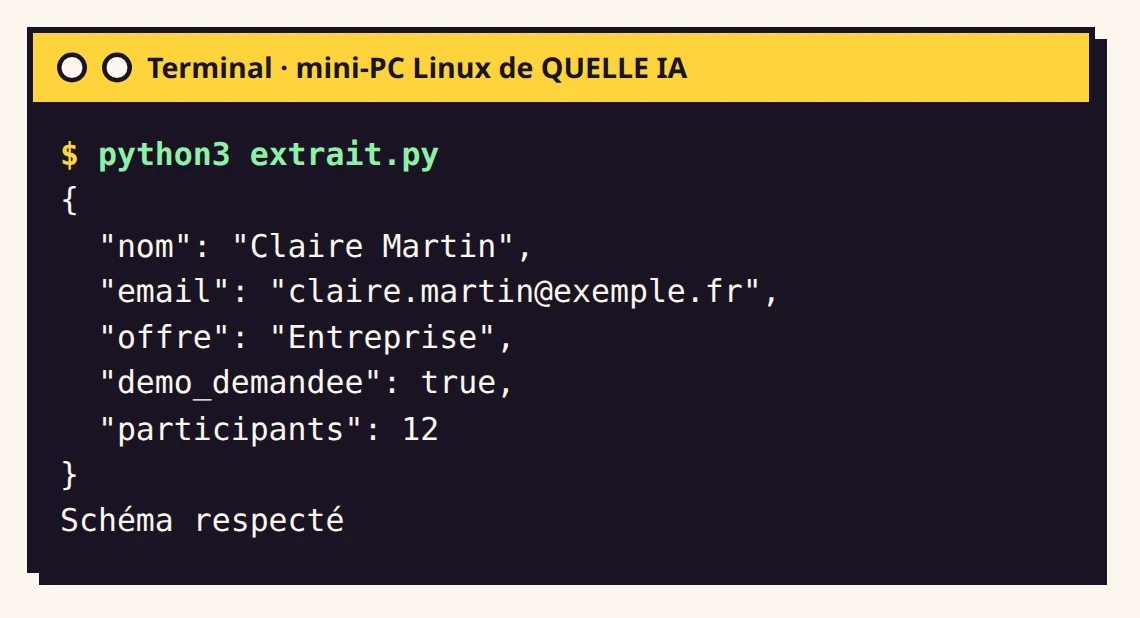
Le modèle a converti « douze personnes » en entier et choisi « Entreprise » dans la liste. Le schéma garantit le type et la liste ; il ne garantit pas que la valeur est juste, d’où la vérification dans le code.
Les appels d’outils avec Ollama passent par le champ tools de /api/chat. Le guide sur la construction d’un agent en donne un exemple complet et exécuté.
Le même travail chez les éditeurs
Aucun des exemples de cette partie n’a été exécuté sur le mini-PC de QUELLE IA (ils demandent une clé d’API payante). Ils reprennent la documentation de chaque éditeur lue le 17 novembre 2026, avec les noms de modèles qu’elle utilise.
Anthropic
Le schéma passe dans output_config.format. Le SDK Python accepte directement un modèle Pydantic avec messages.parse :
# pip install anthropic pydantic ; variable ANTHROPIC_API_KEY
from anthropic import Anthropic
from pydantic import BaseModel


class Contact(BaseModel):
    nom: str
    email: str
    offre: str
    demo_demandee: bool


client = Anthropic()
reponse = client.messages.parse(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Extrais les informations : Claire Martin ([email protected]) "
                                          "veut une démonstration de l'offre Entreprise."}],
    output_format=Contact,
)
print(reponse.parsed_output)
Pour un outil, ajoutez "strict": true à sa définition, à côté de name, description et input_schema : le champ input de l’appel suit alors le schéma, et le nom de l’outil est toujours valide.
OpenAI
Avec l’API Responses, le SDK Python accepte aussi un modèle Pydantic, par responses.parse et le paramètre text_format :
# pip install openai pydantic ; variable OPENAI_API_KEY
from openai import OpenAI
from pydantic import BaseModel


class Contact(BaseModel):
    nom: str
    email: str
    offre: str
    demo_demandee: bool


client = OpenAI()
reponse = client.responses.parse(
    model="gpt-6.2-astra",
    input=[{"role": "user", "content": "Extrais les informations : Claire Martin ([email protected]) "
                                       "veut une démonstration de l'offre Entreprise."}],
    text_format=Contact,
)
print(reponse.output_parsed)
Pour un outil, la définition porte "strict": True et des parameters avec "additionalProperties": False. Le modèle renvoie un élément function_call ; vous renvoyez le résultat dans un élément function_call_output qui reprend son call_id.
Gemini
La documentation de Google utilise désormais son API Interactions. Le schéma passe dans response_format, et la réponse se valide avec Pydantic :
# pip install google-genai pydantic
from google import genai
from pydantic import BaseModel


class Contact(BaseModel):
    nom: str
    email: str
    offre: str
    demo_demandee: bool


client = genai.Client()
interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Extrais les informations : Claire Martin ([email protected]) veut une démonstration de l'offre Entreprise.",
    response_format={"type": "text", "mime_type": "application/json", "schema": Contact.model_json_schema()},
)
print(Contact.model_validate_json(interaction.output_text))
Un serveur local compatible OpenAI
llama-server, vLLM et Ollama acceptent aussi des sorties structurées par leur API compatible OpenAI, d’après leurs documentations (champ response_format pour Ollama ; vLLM détaille ses propres paramètres). Le guide sur les serveurs d’inférence explique comment les lancer.
Les erreurs courantes
additionalPropertiesoublié. OpenAI et Anthropic exigent"additionalProperties": falsesur chaque objet du schéma, sinon la requête est refusée. Les SDK l’ajoutent quand vous passez un modèle Pydantic.- Des champs facultatifs. Chez OpenAI, tous les champs doivent figurer dans
required; pour un champ facultatif, déclarez un type qui acceptenull. Chez Anthropic, chaque paramètre facultatif agrandit la grammaire, et la documentation fixe un plafond de 24 paramètres facultatifs par requête. - Des contraintes ignorées. Anthropic refuse
minimum,maximum,minLengthetmaxLengthdans le schéma envoyé (ses SDK les déplacent dans la description et les vérifient après coup). Gemini retire en silence plusieurs contraintes, dontminLengthetmaxLength. Revalidez dans votre code avec Pydantic ou Zod. - Un JSON coupé. Si la réponse atteint la limite de jetons (
stop_reason: "max_tokens"chez Anthropic), le JSON est incomplet. Relancez avec une limite plus haute. - Un refus. Un modèle peut refuser une demande pour des raisons de sécurité ; chez Anthropic,
stop_reasonvaut alors"refusal"et la sortie peut ne pas suivre le schéma. Testez ce cas avant d’appelerjson.loads. - Un champ « raisonnement » dans le schéma. Anthropic prévient qu’un champ qui réclame le raisonnement pas à pas du modèle peut provoquer un refus ; demandez plutôt une courte explication.
- La casse des valeurs. Anthropic ne garantit pas la casse des valeurs d’une liste fermée (
enum) : « Conversation topic 3 » peut revenir en « Conversation Topic 3 ». Comparez sans tenir compte de la casse. - La première requête plus lente. La grammaire se compile au premier usage d’un schéma, puis reste en cache 24 heures chez Anthropic. Ne mesurez pas la latence sur le premier appel.
- Un outil qui plante. Renvoyez l’erreur au modèle comme résultat d’outil, avec un message clair (« document introuvable, appelle liste_documents »), plutôt que d’arrêter le programme : le modèle peut corriger son appel.
Coût
Le schéma compte dans les jetons d’entrée. Chez Anthropic, la fonction ajoute aussi une consigne système facturée, et changer de schéma invalide le cache de la conversation. Un schéma court, aux noms de champs explicites, coûte peu et guide mieux le modèle. En local, la contrainte ne coûte que le calcul de la grammaire, négligeable face à la génération.
Pour aller plus loin
- Outils de code et agents
- Classement Agents des modèles de langage
- Classement Code des modèles de langage
- Quel modèle sur ma machine
- Construire un agent : la boucle, les outils et les garde-fousNiveau Nerd 30 min
- MCP : brancher des outils dans Claude, ChatGPT ou un agentNiveau Amateur 15 min
- Évaluer un modèle soi-même : un petit banc d'essai maisonNiveau Nerd 20 min
- Réduire la facture d'une API d'IA : cache, lots, modèle, effortNiveau Expert 20 min
- Claude Code en pratique : terminal, IDE, bureau et webNiveau Amateur 14 min
- Coder avec Gemini : Antigravity, Canvas, et la fin de JulesNiveau Amateur 12 min
- Codex, l'agent de code d'OpenAI : terminal, éditeur, appli, nuageNiveau Amateur 15 min
Pour monter son atelier d'IA à la maison, mini lab AI, du même auteur, va plus loin.
Sources
- docs.ollama.com, lue le
- docs.ollama.com, lue le
- platform.claude.com, lue le
- platform.claude.com, lue le
- developers.openai.com, lue le
- developers.openai.com, lue le
- aistudio.google.com, lue le
- arxiv.org, lue le
- github.com, lue le
- github.com, lue le