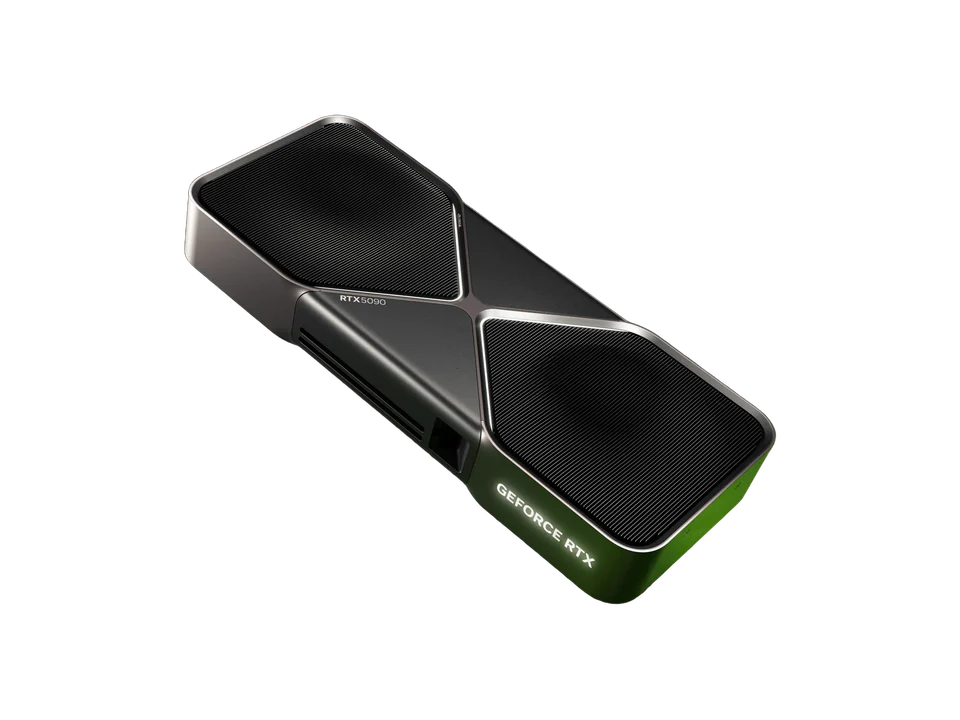
Sur une GeForce RTX 5090, nous comptons 30 Go de mémoire utile (mémoire vidéo moins 2 Go). Le modèle le mieux noté qui y tient, au score général de l'édition du 28 septembre 2026, est Qwen 3.8 27B, avec 82,4, en version allégée à 4 bits (18,6 Go).
Pour faire mieux au score général, il faut viser plus grand : DeepSeek-V4-Flash (82,6, dans la marge d'erreur) demande 196 Go en version allégée à 4 bits, soit deux DGX Spark en grappe.
Prix : 2 099 € au prix du fabricant (nvidia.com, 30 septembre 2026) et 6 799,95 € constatés chez LDLC le 30 septembre 2026.
Ce qui tient, tâche par tâcheEstimation
Pour chaque tâche, le mieux noté parmi les modèles ouverts qui tiennent dans 30 Go utiles, et la version la plus complète qui y entre. La même règle que Trouver mon modèle.
La barre montre la mémoire que demande la version qui tient ; le pointillé, les 30 Go utiles de la machine.
Pour faire mieux
DeepSeek-V4-Flash, mieux noté (82,6, dans la marge d’erreur), demande 196 Go en version allégée à 4 bits : 166 Go de trop pour une GeForce RTX 5090. Il tient à partir de deux DGX Spark en grappe (2 DGX Spark, 256 Go).
La machine
Mémoire
32 Go de GDDR7
Mémoire utile
30 GoMarge de prudencemémoire vidéo moins 2 Go. La mémoire vidéo est la limite. Aucune marge n'est documentée pour l'affichage et le cache : les 2 Go retirés sont une marge de prudence, la même depuis la première édition (22 Go utiles sur 24).
Débit mémoire publié
Non relevé
Sortie
30 janvier 2025
Prix conseillé
2 099 €prix conseillé affiché par Nvidia France (« MSRP 2.099 € ») ; Nvidia ne dit pas s'il est toutes taxes comprises. nvidia.com, 30 septembre 2026.
Prix constaté
6 799,95 €LDLC, 30 septembre 2026 : carte neuve la moins chère en stock (ASUS ROG Astral LC). ldlc.com.
À savoir
Prix de lancement aux États-Unis : 1 999 $ (communiqué du 6 janvier 2025).
Ce que le fabricant écrit sur une page publique. Ce n'est pas notre calcul : le modèle qu'il cite peut demander une version plus compressée que la nôtre.
Repères de vitesse
Mesuré par un tiers205 jetons/sGPT-OSS 20B · MXFP4GeForce RTX 5090 Founders Edition. Ollama. Décodage, une requête à la fois.LMSYS, 13 octobre 2025 · lmsys.org · licence MIT
Mesuré par un tiers271,4 jetons/sLlama 3.2 3BGeForce RTX 5090, avec un processeur Intel 13900K. Ollama (étiquette llama3.2:3b). Débit de génération rapporté par Ollama, quantification non précisée.un contributeur du dépôt de Jeff Geerling, 8 février 2025 · github.com · licence MIT
Déclaré par Nvidia131 jetons/sQwen3.8 27B · Q4_K_MGeForce RTX 5090, avec un Intel Core Ultra 9 285K. llama.cpp, avec la prédiction de plusieurs jetons (MTP, n_max = 3). Banc speedbench, Windows 11, pilote 610.43 ; 77 jetons par seconde sans la prédiction de plusieurs jetons.Nvidia, 11 août 2026 · blogs.nvidia.com
Des repères, pas des comparaisons : modèle, moteur et conditions changent d'une ligne à l'autre. Comment les lire.