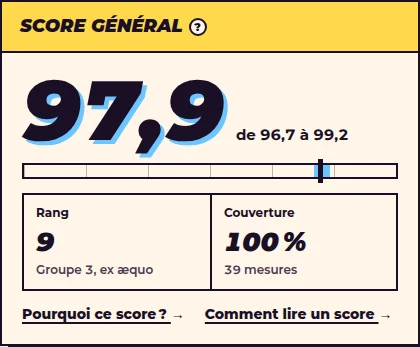
Chaque modèle de langage classé sur QUELLE IA porte un score IA. Il estime le niveau du modèle, toutes tâches confondues, à partir des benchmarks publics où il a été mesuré. Un score ne se lit jamais seul : il vient avec une marge, un rang et une couverture.
L’échelle : deux repères fixes
L’échelle est fixée une fois pour toutes. 50 est le score de GPT-4o de novembre 2024, et 100 celui de Claude Opus 5.5, le meilleur modèle au lancement du site, le 28 septembre 2026. Un modèle plus fort que ce dernier dépasse 100. Un score de 80 se situe donc entre les deux repères, aux trois cinquièmes du chemin.
La marge : où se trouve le vrai niveau
La marge donne l’intervalle où se trouve le score, avec une confiance de 90 % : le vrai niveau a neuf chances sur dix d’y être. Elle s’élargit quand un modèle est peu mesuré, car chaque mesure a sa part de hasard et le score bougerait un peu avec d’autres benchmarks.
Ex æquo, groupe et rang
Deux modèles dont les marges se recouvrent sont ex æquo : l’écart entre leurs scores est plus petit que l’incertitude. Le classement les range par groupes, et un groupe réunit les modèles dont la marge recouvre celle de son premier. Le rang suit l’ordre des scores ; à l’intérieur d’un groupe, les écarts de rang restent dans l’incertitude.
Pour choisir, regardez d’abord le groupe : entre deux modèles du même groupe, le prix, la vitesse ou l’outil dans lequel vous les trouvez comptent davantage.
Couverture et score provisoire
La couverture est la part du poids des tâches (raisonnement, code, agents, français…) où le modèle a au moins une mesure. Un score est provisoire quand il repose sur trop peu de choses : moins de quatre mesures, moins de la moitié du poids des tâches, ou moins de deux sources indépendantes. Le modèle garde son score et sa marge, sans rang.
Le haut du classement cette semaine
Le haut du classement général
- Claude Fable 5.2Anthropic105,2
- Gemini 4 CarbonGoogle DeepMind102,0
- Claude Opus 5.5Anthropic100,6
- GPT-6 AstraOpenAI100,1
- GPT-6.1 TerraOpenAI99,3
Score IA, édition du 16 novembre 2026. Deux modèles dont les marges se recouvrent sont ex æquo.
Bon à savoir. Sur chaque fiche, le « ? » rond à côté du score mène à l’explication de la page La démarche. Pour mettre deux modèles côte à côte, utilisez le comparateur.
Pour aller plus loin
- Benchmark d'IA : ce qu'il mesure et pourquoi il satureNiveau Amateur 4 min
- Par où commencer avec l'IA : quatre parcoursNiveau Débutant 5 min
- Fenêtre de contexte : ce que veut dire « 1 million de jetons »Niveau Débutant 2 min
- Modèle de réflexion : penser avant de répondreNiveau Débutant 2 min
- Paramètres et paramètres actifs : la taille d'une IANiveau Débutant 2 min
Pour monter son atelier d'IA à la maison, mini lab AI, du même auteur, va plus loin.