Un plongement (embedding en anglais) est une liste de nombres qui représente le sens d’un texte. Un modèle spécialisé lit une phrase et rend, par exemple, 768 nombres. Deux phrases qui disent à peu près la même chose donnent deux listes proches, même si elles n’ont aucun mot en commun. On peut alors comparer des textes avec de simples calculs, sans faire appel à un modèle de langage à chaque fois.
À quoi ça sert
- Chercher par le sens. « Comment me faire rembourser un billet de train ? » retrouve « Les billets sont remboursés par l’application Dépenses », qu’aucune recherche par mots-clés n’aurait rapproché. C’est la base d’un RAG.
- Classer. On calcule le plongement de quelques exemples par catégorie, puis on range chaque nouveau texte dans la catégorie la plus proche : tri de tickets de support, d’avis clients, de courriels.
- Dédoublonner. Deux articles sur la même annonce, deux fiches produits presque identiques : leurs plongements sont très proches.
- Regrouper. Des milliers de commentaires se rangent en groupes de sujets, qu’on lit ensuite par échantillons.
Comment ça marche
Le modèle de plongement est un réseau de neurones entraîné sur des paires de textes liés (une question et sa réponse, un titre et son article). On lui apprend à rapprocher les vecteurs des paires liées et à éloigner les autres. La fiche de nomic-embed-text décrit cet entraînement : d’abord des paires faiblement liées tirées de forums, d’avis et d’articles, puis des paires de meilleure qualité issues de recherches web.
Pour comparer deux vecteurs, on mesure l’angle qui les sépare par son cosinus. Il vaut 1 quand les vecteurs pointent dans la même direction, et baisse quand le sens s’éloigne. La route /api/embed d’Ollama rend des vecteurs déjà ramenés à une longueur de 1 : le cosinus se réduit alors à un produit scalaire, une multiplication terme à terme suivie d’une somme.
Deux détails changent les résultats :
- Les préfixes de tâche. Certains modèles veulent savoir ce qu’ils encodent. nomic-embed-text exige
search_document:devant un document,search_query:devant une question,clustering:pour regrouper etclassification:pour classer. - La taille du vecteur. Avec l’apprentissage dit « Matryoshka », les premiers nombres du vecteur portent l’essentiel du sens. On peut garder 256 nombres sur 768 pour stocker trois fois moins, en perdant peu : la fiche de nomic-embed-text v1.5 donne 62,28 au banc MTEB en 768 dimensions et 61,04 en 256. La route
/api/embedaccepte un champdimensionspour les modèles qui le permettent.
Calculer des plongements en local
Ollama sert des modèles de plongement comme les autres, par la route /api/embed. Les exemples suivants n’utilisent que la bibliothèque standard de Python.
- Téléchargez un modèle de plongement :
ollama pull nomic-embed-text
- Testez la route d’un appel. Le champ
inputaccepte un texte ou une liste de textes, et la réponse contient un vecteur par texte :
curl -s http://localhost:11434/api/embed \
  -d '{"model": "nomic-embed-text", "input": ["search_query: Bonjour"]}' | head -c 200
- Enregistrez ce script sous
voisins.py. Il classe des phrases par proximité avec une question, une fois en anglais, une fois en français :
"""Plongements avec Ollama : similarité cosinus entre une question et quelques phrases.
Aucune dépendance : Python 3.10 ou plus et Ollama (ollama pull nomic-embed-text)."""
import json, urllib.request

def plonge(textes, modele="nomic-embed-text"):
    req = urllib.request.Request("http://localhost:11434/api/embed",
                                 data=json.dumps({"model": modele, "input": textes}).encode(),
                                 headers={"Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=120) as r:
        return json.load(r)["embeddings"]

def cosinus(a, b):
    # Les vecteurs d'Ollama sont déjà de longueur 1 : le produit scalaire donne le cosinus.
    return sum(x * y for x, y in zip(a, b))

def classe(question, phrases):
    vecteurs = plonge([f"search_query: {question}"] + [f"search_document: {p}" for p in phrases])
    q, docs = vecteurs[0], vecteurs[1:]
    print(f"Dimensions : {len(q)}")
    for score, p in sorted(((cosinus(q, d), p) for d, p in zip(docs, phrases)), reverse=True):
        print(f"  {score:.3f}  {p}")

if __name__ == "__main__":
    classe("How do I get my train ticket refunded?", [
        "Train tickets are refunded within 30 days through the expense app.",
        "A business lunch is reimbursed up to 35 euros per person.",
        "Each new employee receives a laptop on their first day.",
    ])
    classe("Comment me faire rembourser un billet de train ?", [
        "Les billets de train sont remboursés sous 30 jours par l'application Dépenses.",
        "Un repas d'affaires est remboursé jusqu'à 35 euros par personne.",
        "Chaque nouvel arrivant reçoit un PC portable le jour de son arrivée.",
    ])
- Pour repérer des doublons, enregistrez à côté
doublons.py, qui compare chaque paire de titres :
"""Repérer des doublons : on compare chaque paire de titres et on signale celles au-dessus d'un seuil."""
import itertools
from voisins import plonge, cosinus  # même dossier que voisins.py

titres = [
    "Apple lance un nouvel iPad Pro avec puce M6",
    "L'iPad Pro passe à la puce M6, annonce Apple",
    "Samsung présente le Galaxy S27 Ultra",
    "Le prix du Galaxy S27 Ultra fuite avant l'annonce",
]
vecteurs = plonge([f"clustering: {t}" for t in titres])
for (i, a), (j, b) in itertools.combinations(enumerate(vecteurs), 2):
    s = cosinus(a, b)
    print(f"{s:.3f}  {'DOUBLON ' if s >= 0.9 else '        '} {titres[i][:34]:<34} | {titres[j][:34]}")
- Lancez les deux :
python3 voisins.py
python3 doublons.py
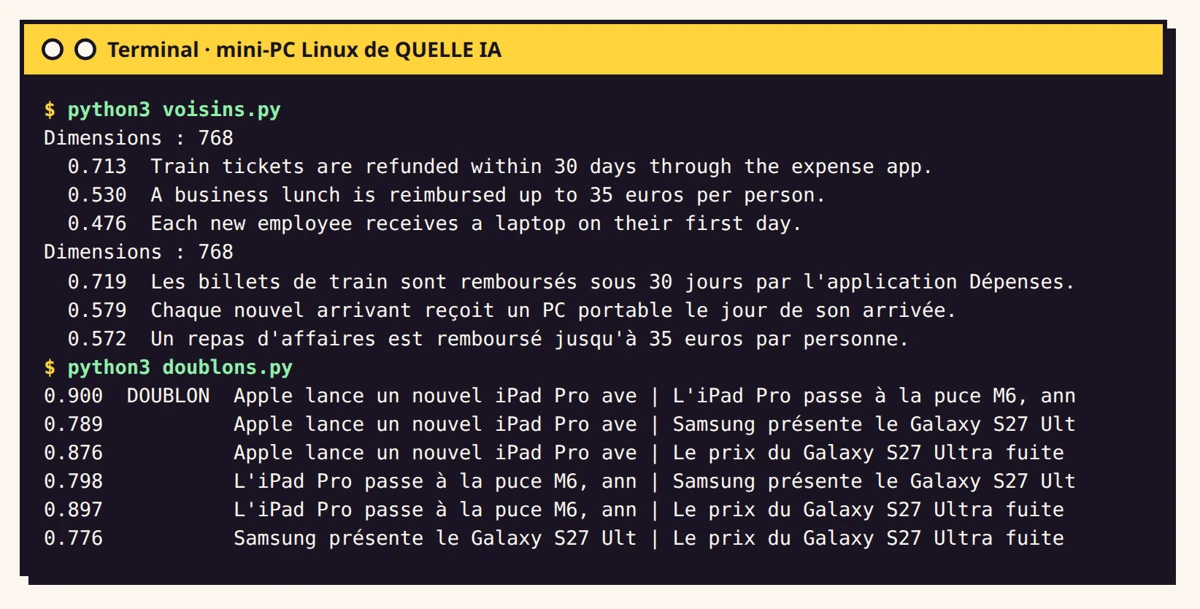
Les deux sorties disent la même chose. En anglais, la bonne phrase devance la deuxième de 0,18 ; en français, l’écart tombe à 0,14 et les deux phrases sans rapport échangent leur place. Pour les doublons, la vraie paire obtient 0,900 et une paire sans rapport (l’iPad Pro et le prix d’un Galaxy) 0,897. Le seuil de 0,9 de l’exemple ne sépare donc presque rien.
Les pièges
- Un seuil fixé au jugé. Un score de similarité n’a pas de sens absolu : il dépend du modèle, de la langue et du préfixe. Prenez une centaine de paires que vous avez jugées à la main (doublon ou non), calculez les scores, et choisissez le seuil qui les sépare le mieux.
- Un modèle mal adapté à la langue. La fiche de nomic-embed-text ne parle que d’anglais, et l’exemple montre des scores tassés en français. Ollama propose des modèles annoncés comme multilingues : embeddinggemma (300 millions de paramètres, plus de 100 langues selon Google), bge-m3 (plus de 100 langues, textes jusqu’à 8 192 jetons) et qwen3-embedding (0,6, 4 et 8 milliards de paramètres). Comparez-les sur vos propres textes avec le guide sur l’évaluation.
- Mélanger deux modèles. Les vecteurs de deux modèles, ou de deux versions d’un même modèle, ne se comparent pas. Changer de modèle oblige à tout recalculer.
- Des textes trop longs. Ollama sert nomic-embed-text avec une fenêtre de 2 048 jetons alors que le modèle en accepte 8 192, et tronque en silence ce qui dépasse. Un plongement résume aussi moins bien un long texte qui parle de plusieurs sujets : découpez-le.
- Oublier les préfixes. Sans
search_query:etsearch_document:, nomic-embed-text marche encore, mais moins bien, et sans aucun message d’erreur.
Coût et matériel
Les modèles de plongement sont petits : 274 Mo pour nomic-embed-text, 300 millions de paramètres pour embeddinggemma. Ils tiennent à côté d’un modèle de discussion sur la plupart des machines. Sur le mini-PC de QUELLE IA, le script voisins.py complet (huit plongements, modèle déjà chargé) a pris moins d’une demi-seconde.
Le stockage se calcule à l’avance : un vecteur de 768 nombres en virgule flottante sur 4 octets pèse environ 3 Ko, soit environ 3 Go pour un million de morceaux. En garder 256 nombres, quand le modèle le permet, divise ce poids par trois.
Pour aller plus loin
- RAG : donner ses documents à un modèle, pas à pasNiveau Nerd 25 min
- Évaluer un modèle soi-même : un petit banc d'essai maisonNiveau Nerd 20 min
- Faire tourner une IA sur son ordinateur avec OllamaNiveau Débutant 15 min
- LM Studio, l'IA locale sans ouvrir de terminalNiveau Débutant 12 min
- Les modèles Mistral en local avec Ollama ou LM StudioNiveau Amateur 12 min
- Quel modèle d'IA pour ma machine, de 8 à 128 GoNiveau Amateur 12 min
Pour monter son atelier d'IA à la maison, mini lab AI, du même auteur, va plus loin.
Sources
- docs.ollama.com, lue le
- docs.ollama.com, lue le
- huggingface.co, lue le
- ollama.com, lue le
- ollama.com, lue le
- ollama.com, lue le
- ollama.com, lue le
- arxiv.org, lue le