Mistral AI publie les poids de la plupart de ses modèles sur Hugging Face, souvent sous licence Apache 2.0. Vous pouvez donc les télécharger et les faire tourner sur votre ordinateur : rien ne part sur Internet, et ils fonctionnent sans connexion. La seule vraie question est la mémoire. Un modèle doit tenir dans la mémoire de la carte graphique, ou dans la mémoire unifiée d’un Mac ou d’une puce comme le Ryzen AI Max.
Quel modèle pour quelle machine
- Ministral 3 (3, 8 et 14 milliards de paramètres) est la famille pensée pour les appareils. Elle lit du texte et des images, existe en version classique et en version qui raisonne, sous licence Apache 2.0. Dans Ollama, la version 8B pèse 6 Go et tient sur un PC portable avec 16 Go de mémoire.
- Devstral Small 2 (24 milliards) est taillé pour les agents de code. Ollama le livre en 15 Go ; Mistral parle d’une carte graphique de 24 Go en 4 bits pour un usage confortable.
- Mistral Small 3.2 et Magistral (24 milliards chacun) sont des modèles généralistes plus anciens, autour de 14 à 15 Go. Dans Ollama,
magistralcorrespond à une version de 2025, avec un contexte de 39 000 jetons. - Mistral Small 4 (119 milliards, dont 6,5 milliards actifs) unit les modèles classique, de réflexion et de code. Il est rapide pour sa taille, mais tous ses paramètres doivent tenir en mémoire : 72 Go environ en 4 bits, et 65 Go de mémoire minimale selon LM Studio.
- Devstral 2 (123 milliards, 75 Go dans Ollama) et Mistral Medium 3.5 (128 milliards, 80 Go) demandent une machine de 128 Go.
- Mistral Large 4 ne tient sur aucune machine que suit QUELLE IA. Sa fiche l’estime à 690 Go en version allégée à 4 bits, et Ollama ne le propose qu’en version « cloud », qui tourne sur ses serveurs.
Bon à savoir. Le poids du fichier ne suffit pas : prévoyez quelques gigaoctets de plus pour la mémoire de travail, qui grandit avec la longueur de la conversation. Le guide Quel modèle pour ma machine détaille ce calcul.
Le 28 octobre 2026, Mistral a annoncé à Frandroid une famille de modèles plus petits tirés de Large 4 « dans le mois qui vient », dont l’un tournerait sur un PC portable. Le 17 novembre, aucun n’était encore publié sur la page Hugging Face de Mistral.
Avec Ollama, en ligne de commande
Ollama télécharge le modèle et le fait tourner en une commande. Installez-le d’abord :
Installer Ollama sur Mac
- Site de l'éditeur Fichier Ollama.dmg ou commande d'installation ; macOS 14 Sonoma ou plus récent · relevé le 17 octobre 2026
- Dépôt officiel Ollama.dmg et archive Ollama-darwin.zip dans les versions GitHub · relevé le 17 octobre 2026
Installer Ollama sur Windows
- Site de l'éditeur Installateur OllamaSetup.exe ou commande PowerShell ; Windows 10 22H2 ou plus récent · relevé le 17 octobre 2026
- Dépôt officiel OllamaSetup.exe et archives x64 et ARM64 dans les versions GitHub · relevé le 17 octobre 2026
Installer Ollama sur Linux
- Site de l'éditeur Script d'installation en une ligne ; installation manuelle décrite dans la documentation · relevé le 17 octobre 2026
- Gestionnaire de paquets Image Docker officielle ollama/ollama · relevé le 17 octobre 2026
- Dépôt officiel Archives x64 (dont variante ROCm) et ARM64 (dont Jetson) dans les versions GitHub · relevé le 17 octobre 2026
Puis lancez le modèle voulu. Le premier lancement télécharge les fichiers ; ensuite, la conversation s’ouvre dans le terminal.
ollama run ministral-3          # Ministral 3 8B, 6 Go (version par défaut)
ollama run ministral-3:3b       # la plus petite, 3 Go
ollama run ministral-3:14b      # 9,1 Go
ollama run devstral-small-2     # pour le code, 15 Go
ollama run mistral-small3.2     # généraliste, 15 Go
ollama run mistral-medium-3.5   # 80 Go, machine de 128 Go
Pour poser une question sans ouvrir de conversation :
ollama run ministral-3 "Résume en cinq points les avantages d'une pompe à chaleur."
Quelques commandes utiles :
ollama list                 # les modèles déjà téléchargés
ollama show ministral-3     # taille, contexte, quantification, capacités
ollama ps                   # les modèles chargés en mémoire
ollama rm mistral-small3.2  # supprimer un modèle
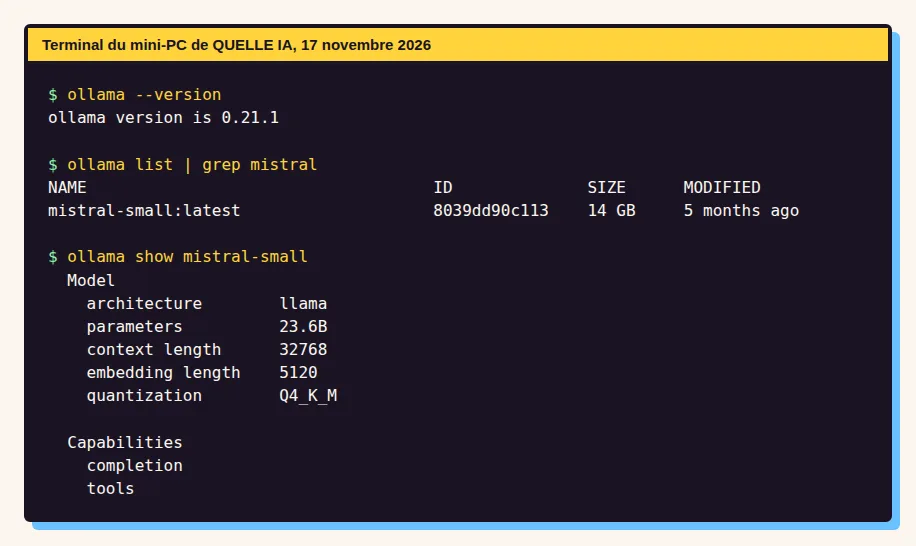
Ollama ouvre aussi un serveur local, sur le port 11434, compatible avec l’API d’OpenAI. Une appli ou un agent de code peut s’y brancher, comme l’explique le guide Ollama pas à pas.
Avec LM Studio, sans terminal
- Installez LM Studio depuis lmstudio.ai et ouvrez-le.
- Ouvrez l’onglet de recherche des modèles et tapez « Mistral » ou « Ministral ».
- Choisissez une version publiée par mistralai :
ministral-3-8b,ministral-3-14b,devstral-small-2-2512oumistral-small-4. La fiche de LM Studio affiche la mémoire minimale conseillée : 7 Go pour Ministral 3 8B, 10 Go pour la 14B, 16 Go pour Devstral Small 2, 65 Go pour Mistral Small 4. - Téléchargez, puis chargez le modèle et discutez dans l’onglet Chat.
LM Studio propose Mistral Small 4, absent de la bibliothèque d’Ollama le 17 novembre 2026. Le guide LM Studio montre l’interface pas à pas.
Ce que donnent les modèles classés
Ces blocs listent les meilleurs modèles ouverts classés par QUELLE IA qui tiennent sur chaque taille de machine, tous éditeurs confondus. Ils situent les modèles de Mistral parmi les autres.
Pour une machine de 16 Go :
Les meilleurs modèles pour une machine de 16 Go
- Qwen3.5-9Ballégée à 8 bits, 11,7 Goscore 66,1
- Gemma 4 12B ITallégée à 4 bits, 8,3 Goscore 64,8 (provisoire)
- Ministral 3 14Ballégée à 4 bits, 9,7 Goscore 64,8 (provisoire)
- Qwen3-14Ballégée à 4 bits, 10,2 Goscore 62,9
- Qwen3.5-4Bcomplète, 10,7 Goscore 62,9 (provisoire)
Mémoire utile retenue : 14 Go, celle des machines suivies de 16 Go. Score IA de l'édition du 16 novembre 2026, version la plus complète qui tient.
Quel modèle sur ma machine →Les modèles qui tournent en local →
Pour 32 Go :
Les meilleurs modèles pour une machine de 32 Go
- Qwen 3.8 27Ballégée à 4 bits, 18,6 Goscore 83,1
- Gemma 4 31B ITallégée à 4 bits, 21,4 Goscore 75,5
- Qwen3.6 27Ballégée à 4 bits, 19,2 Goscore 75,5
- Muse Glimmerallégée à 4 bits, 20,7 Goscore 73,9
- Gemma 4 26B A4Ballégée à 4 bits, 17,9 Goscore 73,1
Mémoire utile retenue : 30 Go, celle des machines suivies de 32 Go. Score IA de l'édition du 16 novembre 2026, version la plus complète qui tient.
Quel modèle sur ma machine →Les modèles qui tournent en local →
Pour 128 Go :
Les meilleurs modèles pour une machine de 128 Go
- Qwen 3.8 27Bcomplète, 62,1 Goscore 83,1
- Nemotron 3.5 Super VLallégée à 4 bits, 82,8 Goscore 76,1
- Gemma 4 31B ITcomplète, 71,3 Goscore 75,5
- Qwen3.6 27Bcomplète, 63,9 Goscore 75,5
- Muse Glimmercomplète, 69 Goscore 73,9
Mémoire utile retenue : 112 Go, celle des machines suivies de 128 Go. Score IA de l'édition du 16 novembre 2026, version la plus complète qui tient.
Quel modèle sur ma machine →Les modèles qui tournent en local →
Brancher un modèle local dans Vibe
L’agent de code de Mistral accepte un modèle servi sur votre machine. Mistral recommande Devstral Small 2 ou Mistral Small 4, et cite vLLM, llama.cpp, LM Studio et Ollama. Avec Ollama, l’adresse du serveur est http://localhost:11434/v1 :
active_model = "devstral-local"

[[providers]]
name = "ollama"
api_base = "http://localhost:11434/v1"
api_style = "openai"
backend = "generic"

[[models]]
name = "devstral-small-2"
provider = "ollama"
alias = "devstral-local"
max_context_length = 32768   # à régler sur le contexte que sert votre Ollama
Le guide Coder avec Vibe explique où placer ce fichier et comment couper tout appel vers Internet.
Exemples de demandes adaptées à un petit modèle
Corrige l'orthographe et la ponctuation de ce texte sans changer son style.
Voici une capture d'écran d'un message d'erreur. Explique-le simplement et propose deux pistes.
Classe ces vingt courriels par urgence et rédige une réponse courte au plus pressé.
Les limites
- Un modèle de 3 ou 8 milliards de paramètres se trompe davantage qu’un grand modèle en ligne, surtout sur les faits précis : vérifiez ce qui compte.
- Les versions de la bibliothèque d’Ollama ne suivent pas toujours les dernières de Mistral :
magistraly date de 2025 et Mistral Small 4 n’y figure pas. - Plusieurs de ces modèles sont marqués « Deprecated » dans l’API de Mistral (Devstral Small 2, Magistral Small 1.2, Mistral Medium 3.5). Leurs poids restent téléchargeables et utilisables chez vous.
- La licence change d’un modèle à l’autre : Apache 2.0 pour Ministral 3, Small 4 et Devstral Small 2, MIT modifiée pour Devstral 2 et Medium 3.5, licence propre pour Large 4. Lisez-la avant un usage commercial.
Pour aller plus loin
- Quel modèle sur ma machine
- Les modèles qui tournent en local
- Mistral ai
- Mistral large 4
- Mistral Vibe
- Faire tourner une IA sur son ordinateur avec OllamaNiveau Débutant 15 min
- LM Studio, l'IA locale sans ouvrir de terminalNiveau Débutant 12 min
- Quel modèle d'IA pour ma machine, de 8 à 128 GoNiveau Amateur 12 min
- Quantification : Q4, Q8, ce qu'on gagne et ce qu'on perdNiveau Expert 14 min
- Brancher Ollama dans un agent de codeNiveau Expert 25 min
- Mistral Large 4 expliqué : taille, licence, prix et usageNiveau Amateur 12 min
- Plongements (embeddings) : ranger des textes par leur sensNiveau Expert 15 min
- Affiner un modèle : LoRA, QLoRA et quand ça vaut le coupNiveau Nerd 30 min
- La vitesse d'un modèle local : débit mémoire et expertsNiveau Nerd 15 min
Pour monter son atelier d'IA à la maison, mini lab AI, du même auteur, va plus loin.
Sources
- Documentation de Mistral, Models Overview, lue le
- Documentation de Mistral, fiche Ministral 3 8B, lue le
- Documentation de Mistral, fiche Ministral 3 14B, lue le
- Documentation de Mistral, fiche Mistral Small 4, lue le
- Documentation de Mistral, fiche Devstral Small 2, lue le
- Documentation de Mistral, fiche Magistral Small 1.2, lue le
- Documentation de Mistral, fiche Mistral Medium 3.5, lue le
- Documentation de Mistral, Using offline models, lue le
- Ollama, bibliothèque, ministral-3, lue le
- Ollama, bibliothèque, devstral-small-2, lue le
- Ollama, bibliothèque, mistral-small3.2, lue le
- Ollama, bibliothèque, magistral, lue le
- Ollama, bibliothèque, devstral-2, lue le
- Ollama, bibliothèque, mistral-medium-3.5, lue le
- Ollama, bibliothèque, mistral-large-4, lue le
- LM Studio, mistralai/mistral-small-4, lue le
- LM Studio, mistralai/ministral-3-8b, lue le
- LM Studio, mistralai/devstral-small-2-2512, lue le
- Hugging Face, Mistral Small 4 en GGUF (lmstudio-community), lue le
- Hugging Face, carte de Mistral Large 4, lue le
- Frandroid, « Il tournera sur PC portable » : Mistral nous confirme un Large 4 allégé (29 octobre 2026), lue le