Sur un ordinateur, un modèle d’IA doit tenir entier dans la mémoire où il calcule : la mémoire vidéo d’une carte graphique, ou la mémoire unifiée d’un Mac et de certains mini-PC. Le processeur compte beaucoup moins. Pour savoir ce que votre machine peut faire tourner, deux chiffres suffisent : le poids du modèle, et la mémoire que votre machine lui laisse vraiment.
À quoi ça sert
- Avant d’installer Ollama ou LM Studio, savoir quel modèle télécharger pour ne pas remplir le disque de fichiers qui ne tourneront pas.
- Avant d’acheter une machine, comparer ce qu’apportent 32, 64 ou 128 Go, et choisir entre une carte graphique et une machine à mémoire unifiée.
- Quand un modèle rame, comprendre s’il déborde de la mémoire et quelle version plus légère prendre.
Comment ça marche
Le poids d’un modèle
Un modèle se mesure en milliards de paramètres, les nombres qu’il a appris. Chacun prend de la place en mémoire, et cette place dépend de la version du modèle :
| Version | Mémoire par milliard de paramètres |
|---|---|
| Complète (16 bits par paramètre) | 2 Go |
| Allégée à 8 bits | 1,05 Go |
| Allégée à 4 bits | 0,6 Go |
Ces valeurs viennent des formats de llama.cpp (16, 8,5 et 4,89 bits par poids réels). QUELLE IA ajoute 15 % pour la mémoire de la conversation, ce qui suffit pour un contexte court.
Un modèle de 27 milliards de paramètres en version allégée à 4 bits demande donc à peu près 27 × 0,6 × 1,15, soit 18,6 Go. En version complète, il en faudrait 62. Le catalogue d’Ollama sert souvent la version à 4 bits par défaut (qwen3:8b y désigne la version Q4_K_M). Elle perd un peu en précision, et le guide sur la quantification dit combien.
Bon à savoir : les pages de QUELLE IA comptent toujours la version la plus complète qui tient sur la machine. Un modèle qui ne tient qu’en version à 3 ou 2 bits n’y est pas compté.
La mémoire vraiment utile
Une machine de 16 Go ne donne pas 16 Go à un modèle. Le système, l’affichage et les autres applications en gardent une part, qui dépend du matériel.
- Carte graphique : la mémoire vidéo moins 2 Go, marge de prudence pour l’affichage. Une carte de 16 Go laisse 14 Go, une carte de 24 Go en laisse 22.
- Mac : 74 % de la mémoire unifiée. C’est ce que QUELLE IA a mesuré sur un Mac mini M6 de 24 Go, où Ollama voit 17,8 Gio utilisables par le processeur graphique. Apple ne publie pas cette part.
- PC sans carte graphique, 16 Go : 11 Go, le modèle tournant alors sur le processeur, dans la mémoire que lui laissent le système et les applications.
- Ryzen AI Max : le plafond publié par AMD pour sa mémoire graphique, 96 Go sur une machine de 128 Go et 160 Go sur 192 Go (la même proportion, 75 %, sur 32 et 64 Go).
- DGX Spark : 87,5 % de ses 128 Go, soit 112 Go, Nvidia ne documentant aucune part.
- PC portable RTX Spark de 128 Go : 91 Go, le réglage retenu par le test de Frandroid.
- PC portable Intel Core Ultra : 57 % de la mémoire, la part qu’Intel donne par défaut au processeur graphique intégré.
Trouver ce qui tourne sur votre machine
- Relevez votre mémoire. Sur un Mac, ouvrez le menu Pomme, puis « À propos de ce Mac » : la fenêtre affiche la puce et la mémoire. Sous Windows, ouvrez le Gestionnaire des tâches, onglet Performance : chaque processeur graphique y montre sa mémoire dédiée, celle qui compte pour une carte graphique.
- Ouvrez la page « Sur ma machine » de QUELLE IA et tapez le nom de votre machine, de votre carte graphique ou de votre puce, ou choisissez sa famille.
- Sur la page de la machine, lisez la mémoire utile retenue, puis les modèles qui y tiennent, tâche par tâche, avec la version qui entre (complète, 8 bits ou 4 bits).
- Notez le nom du modèle et sa version, puis cherchez-le dans Ollama ou LM Studio : le guide sur la quantification explique comment demander une version précise.
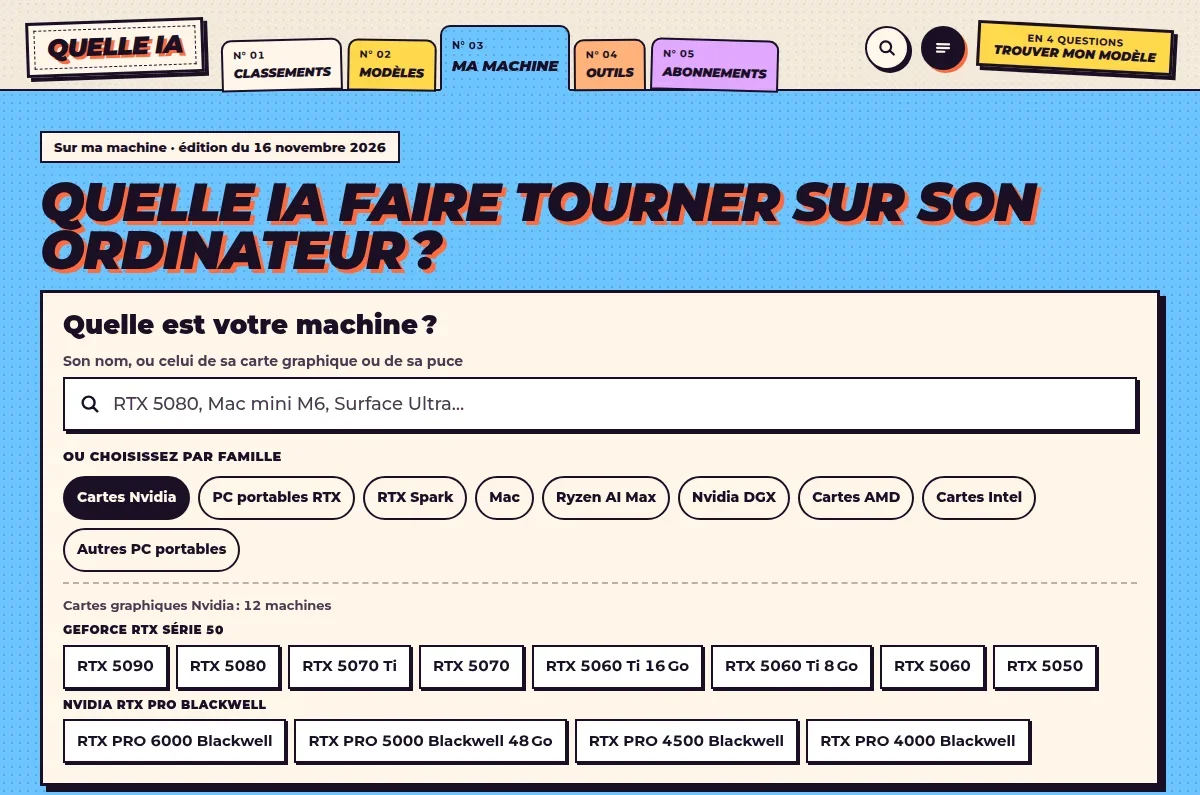
Si votre machine n’est pas dans la liste, la page « Trouver mon modèle » pose quatre questions et donne la même réponse à partir de votre mémoire.
Carte graphique ou mémoire unifiée
Les deux familles ne font pas le même compromis.
Une carte graphique a peu de mémoire, mais très rapide. Une Radeon RX 7900 XTX lit sa mémoire à 960 Go/s, d’après les données du registre de QUELLE IA. Tant que le modèle tient dans ses 24 Go, il répond vite. Au-delà, il déborde sur la mémoire ordinaire de l’ordinateur et ralentit nettement.
La mémoire unifiée d’un Mac, d’un mini-PC Ryzen AI Max ou d’un DGX Spark est partagée entre le processeur et le processeur graphique. On en trouve beaucoup plus (128 Go et au-delà), le plus souvent plus lente : 153 Go/s sur un Mac mini M6, 273 Go/s sur un DGX Spark. Le Mac Studio M5 Ultra fait exception, à 1 200 Go/s. Un gros modèle y tient, et répond en général moins vite qu’il ne le ferait sur une carte graphique assez grande pour lui.
Ce débit fixe la vitesse d’écriture d’un modèle. Le guide « La vitesse d’un modèle local » détaille le calcul.
Palier par palier
Les listes suivantes donnent les modèles les mieux classés par QUELLE IA qui tiennent dans chaque quantité de mémoire. Elles suivent l’édition de la semaine : un nouveau modèle y entre dès qu’il est classé.
8 Go
C’est le palier d’une carte graphique d’entrée de gamme, qui laisse 6 Go au modèle. On y fait tourner de petits modèles de quelques milliards de paramètres, assez pour des tâches simples comme résumer un texte.
Les meilleurs modèles pour une machine de 8 Go
- Qwen3.5-4Ballégée à 8 bits, 5,6 Goscore 62,9 (provisoire)
- Ministral 3 8Ballégée à 4 bits, 5,5 Goscore 61,5 (provisoire)
- LFM 2 8B A1Ballégée à 4 bits, 5,5 Goscore 61,3 (provisoire)
- Qwen3-8Ballégée à 4 bits, 5,5 Goscore 58,0
- Granite 4.1 8Ballégée à 4 bits, 5,5 Goscore 53,2
Mémoire utile retenue : 6 Go, celle des machines suivies de 8 Go. Score IA de l'édition du 16 novembre 2026, version la plus complète qui tient.
Quel modèle sur ma machine →Les modèles qui tournent en local →
16 Go
Ce palier réunit une carte graphique de 16 Go (14 Go utiles), un Mac de 16 Go (11,8 Go) ou un PC portable de 16 Go sans carte graphique (11 Go). À mémoire égale, la carte graphique a donc plus de place et va plus vite.
Les meilleurs modèles pour une machine de 16 Go
- Qwen3.5-9Ballégée à 8 bits, 11,7 Goscore 66,1
- Gemma 4 12B ITallégée à 4 bits, 8,3 Goscore 64,8 (provisoire)
- Ministral 3 14Ballégée à 4 bits, 9,7 Goscore 64,8 (provisoire)
- Qwen3-14Ballégée à 4 bits, 10,2 Goscore 62,9
- Qwen3.5-4Bcomplète, 10,7 Goscore 62,9 (provisoire)
Mémoire utile retenue : 14 Go, celle des machines suivies de 16 Go. Score IA de l'édition du 16 novembre 2026, version la plus complète qui tient.
Quel modèle sur ma machine →Les modèles qui tournent en local →
32 Go
Une carte graphique de 32 Go laisse 30 Go, un Mac de 32 Go 23,7 Go, une machine Ryzen AI Max de 32 Go 24 Go, un PC portable Intel Core Ultra de 32 Go 18,2 Go. Selon la machine, les modèles d’une vingtaine à une trentaine de milliards de paramètres y deviennent accessibles en version à 4 bits.
Les meilleurs modèles pour une machine de 32 Go
- Qwen 3.8 27Ballégée à 4 bits, 18,6 Goscore 83,1
- Gemma 4 31B ITallégée à 4 bits, 21,4 Goscore 75,5
- Qwen3.6 27Ballégée à 4 bits, 19,2 Goscore 75,5
- Muse Glimmerallégée à 4 bits, 20,7 Goscore 73,9
- Gemma 4 26B A4Ballégée à 4 bits, 17,9 Goscore 73,1
Mémoire utile retenue : 30 Go, celle des machines suivies de 32 Go. Score IA de l'édition du 16 novembre 2026, version la plus complète qui tient.
Quel modèle sur ma machine →Les modèles qui tournent en local →
64 Go
Ce palier est surtout celui de la mémoire unifiée : 47,4 Go utiles sur un Mac de 64 Go, 48 Go sur une machine Ryzen AI Max, 45,5 Go sur un PC portable RTX Spark. Les modèles moyens y tiennent en version à 8 bits, qui reste plus fidèle que celle à 4 bits.
Les meilleurs modèles pour une machine de 64 Go
- Qwen 3.8 27Ballégée à 8 bits, 32,6 Goscore 83,1
- Gemma 4 31B ITallégée à 8 bits, 37,4 Goscore 75,5
- Qwen3.6 27Ballégée à 8 bits, 33,5 Goscore 75,5
- Muse Glimmerallégée à 8 bits, 36,2 Goscore 73,9
- Gemma 4 26B A4Ballégée à 8 bits, 31,4 Goscore 73,1
Mémoire utile retenue : 48 Go, celle des machines suivies de 64 Go. Score IA de l'édition du 16 novembre 2026, version la plus complète qui tient.
Quel modèle sur ma machine →Les modèles qui tournent en local →
128 Go
Le palier des mini-PC et des stations pour l’IA : 112 Go sur un DGX Spark, 96 Go sur une machine Ryzen AI Max, 94,7 Go sur un Mac, 91 Go sur un PC portable RTX Spark. Les grands modèles à mélange d’experts, de plus de cent milliards de paramètres, y tiennent en version à 4 bits.
Les meilleurs modèles pour une machine de 128 Go
- Qwen 3.8 27Bcomplète, 62,1 Goscore 83,1
- Nemotron 3.5 Super VLallégée à 4 bits, 82,8 Goscore 76,1
- Gemma 4 31B ITcomplète, 71,3 Goscore 75,5
- Qwen3.6 27Bcomplète, 63,9 Goscore 75,5
- Muse Glimmercomplète, 69 Goscore 73,9
Mémoire utile retenue : 112 Go, celle des machines suivies de 128 Go. Score IA de l'édition du 16 novembre 2026, version la plus complète qui tient.
Quel modèle sur ma machine →Les modèles qui tournent en local →
Au-delà, il faut un Mac Studio de 256 ou 512 Go, une DGX Station ou plusieurs DGX Spark reliés en grappe. La page des machines de QUELLE IA les détaille une par une.
Trois pièges
Le mélange d’experts. Beaucoup de modèles récents sont des « mélanges d’experts » : ils comptent de nombreux paramètres, mais n’en utilisent qu’une partie pour chaque mot. Qwen3-Coder 30B en a 30,5 milliards, dont 3,3 milliards actifs, selon sa fiche. Tout doit pourtant tenir en mémoire : on compte la mémoire sur le total, et la vitesse sur les actifs. Ces modèles écrivent bien plus vite qu’un modèle dense de même taille.
Le contexte long. Les 15 % ajoutés au poids valent pour une conversation courte. Un agent de code qui garde 64 000 jetons de contexte, la valeur que conseille Ollama pour ce travail, demande plus de mémoire. Ollama règle d’ailleurs le contexte d’après la mémoire vidéo, jusqu’à 256 000 jetons au-delà de 48 Gio : sur une machine juste, réglez-le vous-même (variable OLLAMA_CONTEXT_LENGTH).
Le débordement. Un modèle trop gros ne refuse pas de démarrer. Il est réparti entre le processeur graphique et le processeur, et ralentit nettement. Dans Ollama, ollama ps l’affiche dans sa colonne PROCESSOR (« 48%/52% CPU/GPU », par exemple). Sur une machine dotée d’un processeur graphique, si vous voyez autre chose que « 100% GPU », prenez une version plus légère ou un modèle plus petit.
Bon à savoir : le score d’un modèle sur QUELLE IA est mesuré sur sa version complète. La version allégée qui tourne chez vous fait un peu moins bien.
Pour une réponse sur votre machine précise, la page « Trouver mon modèle » pose quatre questions, et chaque page machine liste ce qui y tient avec la vitesse mesurée ou estimée.
Pour aller plus loin
- Quel modèle sur ma machine
- Les modèles qui tournent en local
- Trouver mon modèle
- Les logiciels d'IA locale
- Quantification : Q4, Q8, ce qu'on gagne et ce qu'on perdNiveau Expert 14 min
- La vitesse d'un modèle local : débit mémoire et expertsNiveau Nerd 15 min
- Faire tourner une IA sur son ordinateur avec OllamaNiveau Débutant 15 min
- LM Studio, l'IA locale sans ouvrir de terminalNiveau Débutant 12 min
- Les modèles Mistral en local avec Ollama ou LM StudioNiveau Amateur 12 min
- Plongements (embeddings) : ranger des textes par leur sensNiveau Expert 15 min
Sur mini lab AI, un guide du même auteur reprend ce sujet pour monter son atelier d'IA à la maison.
Sources
- github.com, lue le
- docs.ollama.com, lue le
- docs.ollama.com, lue le
- huggingface.co, lue le
- huggingface.co, lue le
- support.apple.com, lue le
- devblogs.microsoft.com, lue le
- ollama.com, lue le
- quelleia.com, lue le