Un modèle de langage écrit un jeton à la fois, un jeton étant un morceau de mot. Pour chacun, il refait le même calcul à travers tous ses paramètres actifs, qu’il doit d’abord lire en mémoire. Sur un ordinateur personnel, cette lecture prend plus de temps que le calcul lui-même. La vitesse d’écriture dépend donc d’abord de deux chiffres : le débit de la mémoire, en Go par seconde, et le nombre d’octets à relire pour chaque jeton.
À quoi ça sert
- Prévoir avant d’acheter. Avec le même modèle, deux machines peuvent écrire à des vitesses très différentes : un Mac mini M6 lit sa mémoire à 153 Go/s, un Mac Studio M5 Ultra à 1 200 Go/s, près de huit fois plus, d’après le registre de QUELLE IA.
- Comprendre pourquoi un gros modèle va vite. Un modèle à mélange d’experts de 30 milliards de paramètres peut écrire bien plus vite qu’un modèle dense de 8 milliards.
- Lire nos fourchettes. Les pages machines de QUELLE IA affichent une vitesse estimée pour chaque modèle : ce guide dit d’où elle vient et ce qu’elle ne couvre pas.
Comment ça marche
La mémoire, goulot d’étranglement
Quand un modèle répond à une seule personne, chaque jeton demande de faire passer tous ses paramètres actifs de la mémoire aux unités de calcul. Databricks résume la situation ainsi : à petite échelle, la génération est limitée par la vitesse à laquelle on charge les paramètres depuis la mémoire, et le débit mémoire dicte la vitesse.
Leur exemple chiffré : un modèle de 7 milliards de paramètres en 16 bits pèse 14 Go. S’il écrit un jeton toutes les 14 millisecondes, il fait passer 14 Go en 14 ms, soit 1 To par seconde. Sur une machine capable de 2 To/s, il en utilise la moitié.
La lecture de votre demande, avant le premier mot de la réponse, suit une autre logique : tous les jetons de la demande se traitent d’un bloc, et c’est la puissance de calcul qui compte. Ce guide parle de la génération, ce qui s’écrit une fois la réponse lancée.
Le plafond
On en tire un plafond simple :
vitesse maximale (jetons/s) = débit mémoire (Go/s) ÷ Go relus à chaque jeton
Les Go relus à chaque jeton valent les paramètres actifs, en milliards, multipliés par le poids d’un milliard de paramètres dans la version installée : 0,6 Go à 4 bits, 1,05 Go à 8 bits, 2 Go en version complète (le guide sur la quantification explique ces versions).
Le tableau de llama.cpp sur Llama 3.1 8B le confirme : passer de la version complète à Q8_0 divise la taille par 1,9 et fait monter la génération de 29 à 51 jetons par seconde ; Q4_K_M atteint 72 jetons par seconde. Moins d’octets à relire, plus de jetons.
Dense ou mélange d’experts
Un modèle dense utilise tous ses paramètres pour chaque jeton. Un modèle à mélange d’experts (MoE, pour mixture of experts) découpe une partie de ses couches en « experts », et un petit routeur n’en choisit que quelques-uns par jeton. Hugging Face le résume : l’inférence est bien plus rapide qu’avec un modèle dense de même taille, mais tous les paramètres doivent tenir en mémoire.
Sur le mini-PC de QUELLE IA, deux modèles de code le montrent. Leurs fichiers ont presque la même taille, et leurs architectures diffèrent :
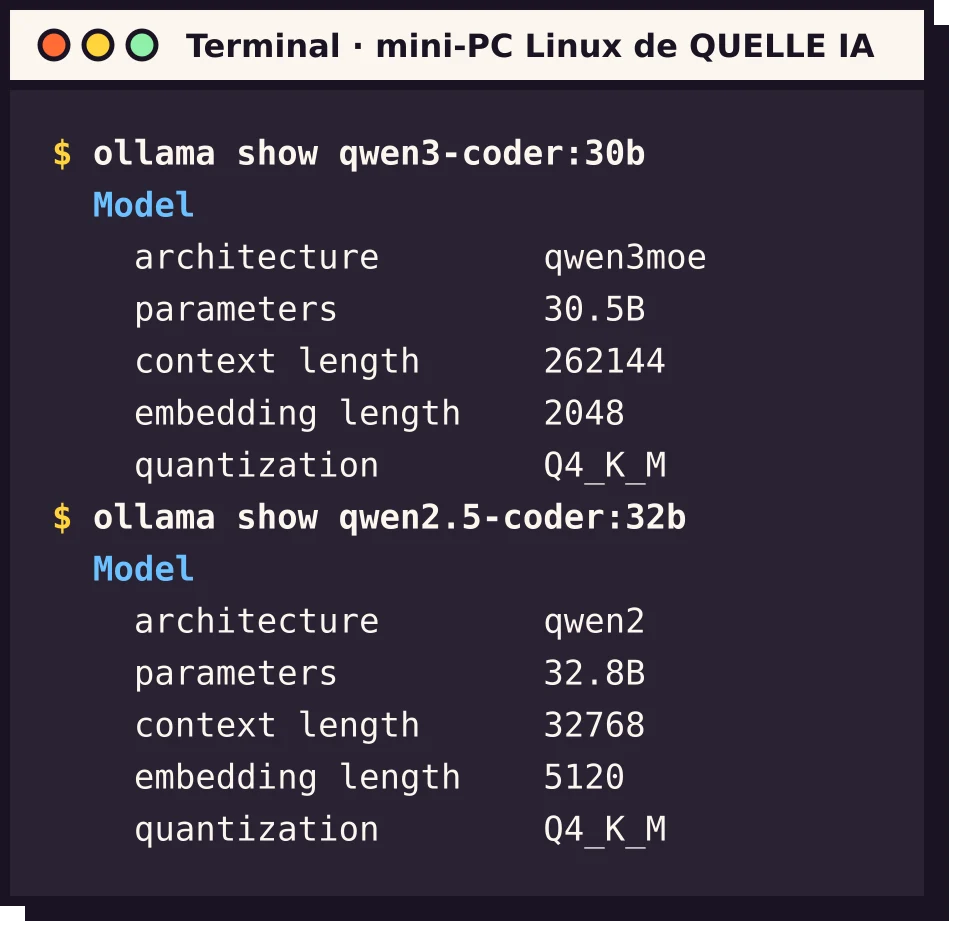
Qwen3-Coder 30B compte 30,5 milliards de paramètres dont 3,3 milliards actifs (128 experts, 8 activés par jeton, selon sa fiche). Qwen2.5-Coder 32B est dense : il relit tous ses paramètres, 32,8 milliards d’après Ollama, à chaque jeton.
À débit égal, le premier relit dix fois moins de mémoire par jeton. Avec le débit d’un DGX Spark (273 Go/s) et la version à 4 bits, le plafond est d’environ 14 jetons par seconde pour le modèle dense et 140 pour le mélange d’experts. Pour la mémoire, en revanche, on compte le total : à 4 bits, les deux demandent de 21 à 23 Go, conversation courte comprise.
Du plafond à la vitesse réelle
Les machines mesurées restent sous ce plafond. Le moteur, le cache de la conversation et les calculs annexes prennent leur part. Le registre de QUELLE IA garde des mesures publiées pour situer l’écart. Le projet llama.cpp a mesuré gpt-oss 120B sur un DGX Spark : 58,72 jetons par seconde en écrivant 32 jetons à contexte vide. Ce modèle active 5,1 milliards de paramètres, rangés au format MXFP4 de 4,25 bits par poids, soit 2,7 Go à relire par jeton. Le plafond est donc de 273 ÷ 2,7, environ 101 jetons par seconde : la mesure en atteint 58 %.
Le contexte compte aussi. Avec 32 768 jetons de conversation déjà en mémoire, la même mesure tombe à 42,76 jetons par seconde : le modèle relit aussi, à chaque jeton, le cache de tout ce qui précède.
Comment QUELLE IA estime la vitesse
Sur chaque page machine, QUELLE IA montre d’abord les vitesses mesurées et publiées quand il y en a. Pour les autres modèles, le site affiche une fourchette estimée, toujours marquée comme telle.
- Le plafond. Débit mémoire de la machine ÷ (paramètres actifs × Go par milliard de la version la plus complète qui tient sur la machine).
- L’étalonnage. Pour chaque mesure publiée dont on connaît la machine, le modèle et le format, le site calcule la part du plafond atteinte. Il retient la plus petite et la plus grande.
- La fourchette. Plafond × la plus petite part, et plafond × la plus grande. Les deux bornes se recalculent à chaque édition : une nouvelle mesure peut les déplacer.
- L’arrondi. Deux chiffres significatifs, sans décimale au-delà de 10 jetons par seconde.
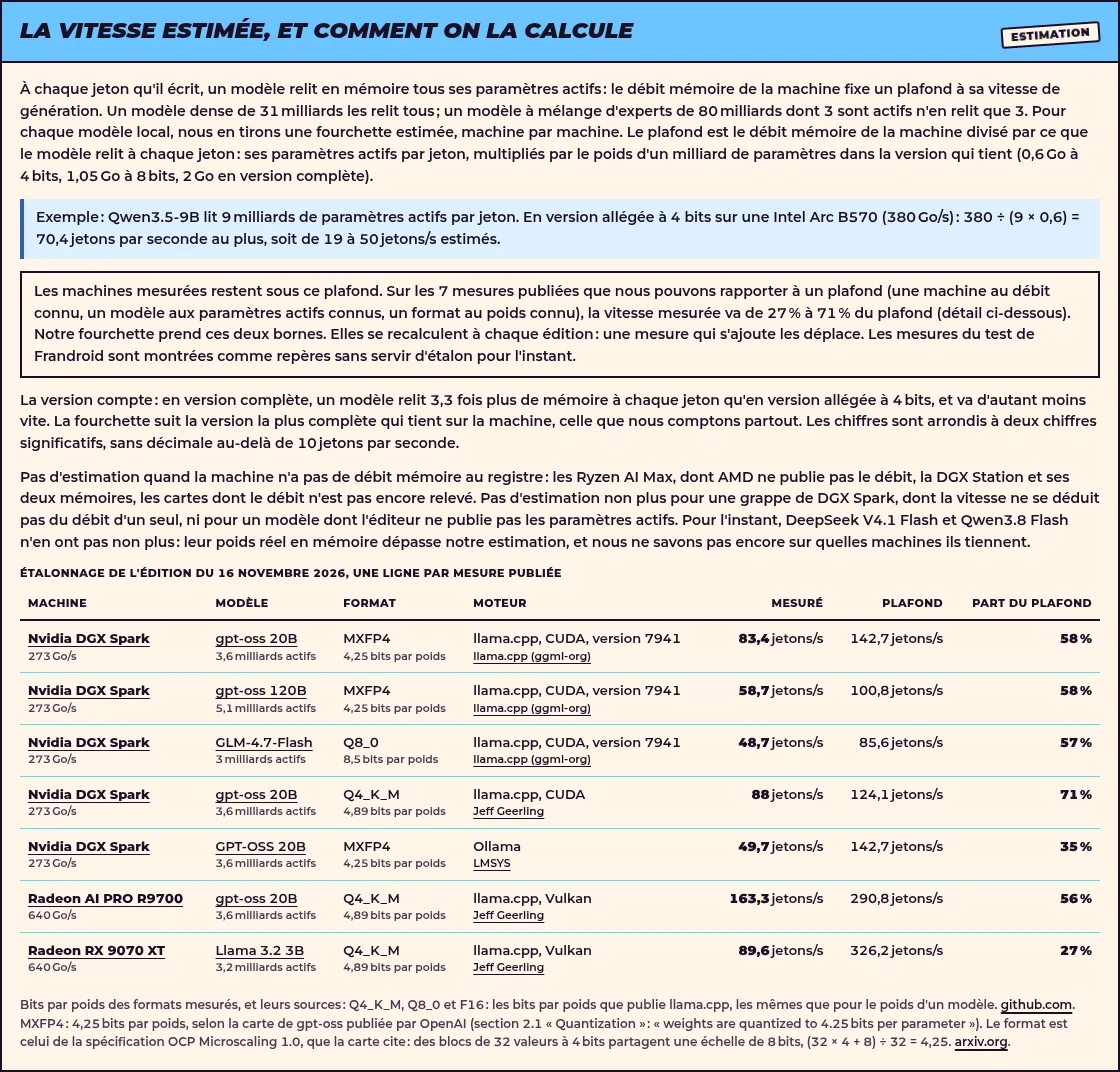
Le site ne donne aucune estimation pour quatre sortes de machines et de modèles : une machine dont le débit mémoire n’est pas publié (les Ryzen AI Max, AMD ne publiant pas ce chiffre), une machine à deux mémoires de débits très différents (la DGX Station), une grappe de plusieurs machines reliées par le réseau, et un modèle dont l’éditeur ne publie pas les paramètres actifs. Quelques modèles dont le poids réel en mémoire reste incertain en sont aussi privés, et leur fiche le dit.
Bon à savoir : l’estimation vaut pour un contexte court. Elle ne compte ni la lecture d’une longue demande, ni les écarts entre moteurs (llama.cpp, Ollama, LM Studio, MLX ou vLLM ne tirent pas le même parti d’une machine), ni la prédiction de plusieurs jetons à la fois, qui peut dépasser le plafond.
Voici, pour une machine de 128 Go, les modèles les mieux classés qui y tiennent. Les pages machines donnent la vitesse estimée de chacun.
Les meilleurs modèles pour une machine de 128 Go
- Qwen 3.8 27Bcomplète, 62,1 Goscore 83,1
- Nemotron 3.5 Super VLallégée à 4 bits, 82,8 Goscore 76,1
- Gemma 4 31B ITcomplète, 71,3 Goscore 75,5
- Qwen3.6 27Bcomplète, 63,9 Goscore 75,5
- Muse Glimmercomplète, 69 Goscore 73,9
Mémoire utile retenue : 112 Go, celle des machines suivies de 128 Go. Score IA de l'édition du 16 novembre 2026, version la plus complète qui tient.
Quel modèle sur ma machine →Les modèles qui tournent en local →
Mesurer sa propre vitesse
Avec Ollama, dans le terminal
- Lancez le modèle avec l’option
--verbose, qui affiche les temps de la réponse :
ollama run --verbose qwen3-coder:30b "Écris une fonction Python qui trie une liste."
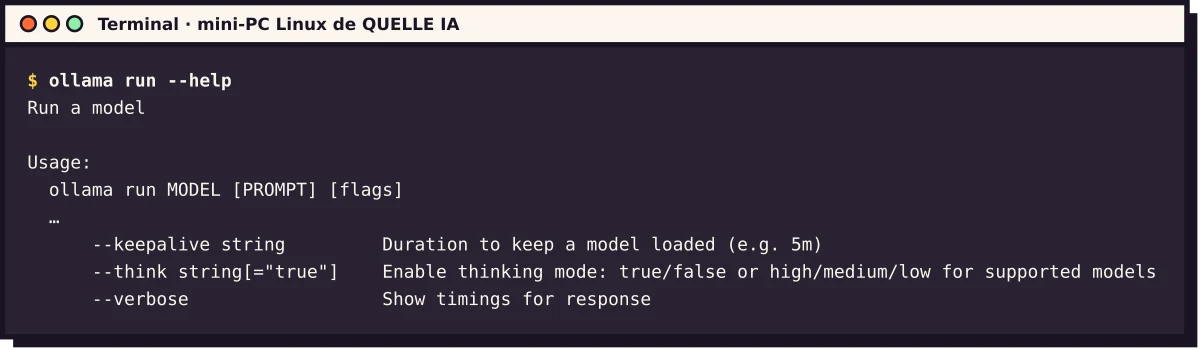
- Sous la réponse, Ollama ajoute ses statistiques. Retenez la vitesse de génération des jetons de la réponse, en jetons par seconde, à distinguer de celle de la lecture de la demande.
- Refaites l’essai deux ou trois fois : le premier lancement inclut le chargement du modèle en mémoire.
- Vérifiez avec
ollama psque la colonnePROCESSORindique « 100% GPU ». Un modèle partagé entre processeur et processeur graphique écrit nettement moins vite que ne le prévoit le calcul.
Avec l’API d’Ollama, pour un script
La réponse de l’API donne eval_count, le nombre de jetons écrits, et eval_duration, le temps qu’il a fallu, en nanosecondes. La vitesse vaut eval_count ÷ eval_duration × 10⁹.
curl -s http://localhost:11434/api/generate \
  -d '{"model": "qwen3-coder:30b", "prompt": "Écris une fonction Python qui trie une liste.", "stream": false}' \
  | python3 -c 'import json,sys; r=json.load(sys.stdin); print(round(r["eval_count"]/r["eval_duration"]*1e9, 1), "jetons/s")'
Pour comparer deux machines ou deux versions d’un modèle, gardez la même demande, la même longueur de réponse et un contexte vide, comme les mesures de référence de llama.cpp.
Pour aller plus loin
- Quantification : Q4, Q8, ce qu'on gagne et ce qu'on perdNiveau Expert 14 min
- Quel modèle d'IA pour ma machine, de 8 à 128 GoNiveau Amateur 12 min
- Faire tourner une IA sur son ordinateur avec OllamaNiveau Débutant 15 min
- LM Studio, l'IA locale sans ouvrir de terminalNiveau Débutant 12 min
- Les modèles Mistral en local avec Ollama ou LM StudioNiveau Amateur 12 min
Sur mini lab AI, un guide du même auteur reprend ce sujet pour monter son atelier d'IA à la maison.
Sources
- databricks.com, lue le
- huggingface.co, lue le
- huggingface.co, lue le
- huggingface.co, lue le
- github.com, lue le
- docs.ollama.com, lue le
- github.com, lue le
- docs.ollama.com, lue le
- quelleia.com, lue le