Lemonade
Lemonade installe sur l'ordinateur un serveur d'IA locale, avec une application et une ligne de commande, pour faire tourner des modèles de texte, d'image, de voix et de transcription sur le processeur, la carte graphique ou le NPU.
Télécharger
- App StoreApp Store, Lemonade pour iPhone et iPad, site officiel (nouvel onglet)
- Google PlayGoogle Play, Lemonade pour Android, site officiel (nouvel onglet)
- Télécharger pour MacPour Mac, Lemonade pour Mac, site officiel (nouvel onglet)
- Télécharger pour WindowsPour Windows, Lemonade pour Windows, site officiel (nouvel onglet)
- Télécharger pour LinuxPour Linux, Lemonade pour Linux, site officiel (nouvel onglet)
Versions et configuration
- App Store : Lemonade Mobile, client qui se connecte à un serveur Lemonade ; iOS 13 ou plus récent
- Google Play : Lemonade Mobile Omni, client qui se connecte à un serveur Lemonade
- Dépôt officiel : Paquet .pkg pour Mac à puce Apple Silicon
- Dépôt officiel : Installeur MSI pour Windows 11
- Site de l'éditeur : Ubuntu 24.04 et plus (PPA), Debian Trixie, Fedora 43 et plus, Arch Linux, Snap
- Paquet : Paquet Snap lemonade-server
Tout pour : iPhone et iPad · Android · Mac · Windows · Linux
Version : v2026.42.1, 14 octobre 2026
- Prix
- Gratuit
- Licence
- open source (Apache-2.0)
- Fonctionne
- Local ou en ligne
- Éditeur
- AMD
Pourquoi il est là : Il tire parti, sans réglage manuel, du NPU des processeurs Ryzen AI 300 et de la puce graphique des PC Strix Halo, tout en restant utilisable sur d'autres PC et sur Mac.
Liens officiels, sans lien affilié.
Télécharger Lemonade sur iPhone
Télécharger Lemonade sur iPhone : configuration, capturesTélécharger Lemonade sur Android
Télécharger Lemonade sur Android : capturesTélécharger Lemonade sur Mac
Télécharger Lemonade sur Mac : configuration, version, limitesTélécharger Lemonade sur PC Windows
Télécharger Lemonade sur PC Windows : configuration, version, limitesTélécharger Lemonade sur Linux
Télécharger Lemonade sur Linux : configuration, version, limitesCe que c'est
Les autres logiciels s'y branchent comme sur les API d'OpenAI, d'Anthropic ou d'Ollama. Ce projet communautaire parrainé par AMD est optimisé pour les puces Ryzen AI, les cartes Radeon et les PC Strix Halo.
À quoi ça sert
- Discuter avec un modèle comme Gemma 4 en une commande (« lemonade run ») ou depuis l'interface web locale. github.com
- Servir un modèle local à des applications compatibles OpenAI, comme Open WebUI, Continue ou AnythingLLM. lemonade-server.ai
- Lancer un agent de code (Claude Code) branché sur un modèle local avec « lemonade launch claude ». github.com
- Générer une image avec SDXL-Turbo, une voix avec Kokoro ou transcrire un enregistrement avec Whisper, sans service en ligne. github.com
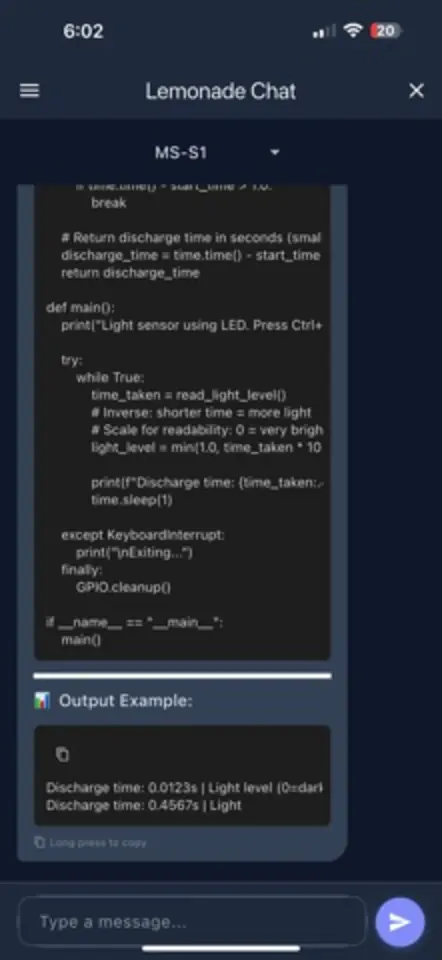
- Converser depuis un téléphone avec un serveur Lemonade de la maison grâce à l'appli Lemonade Mobile. play.google.com
Fonctions
- Choix automatique du moteur
- Lemonade sélectionne le moteur adapté au PC : llama.cpp (Vulkan, ROCm, CUDA, Metal), FastFlowLM ou Ryzen AI pour le NPU, et vLLM sur Strix Halo sous Linux. github.com
- Gestionnaire de modèles
- Catalogue intégré et téléchargement de modèles GGUF ou ONNX depuis Hugging Face ou ModelScope ; les modèles trop lourds pour la machine sont écartés. github.com
- API compatibles
- Points d'accès compatibles OpenAI, Anthropic et Ollama, plus une passerelle MCP. lemonade-server.ai
- Multimodal
- Conversation, vision, génération d'images, synthèse vocale, transcription et embeddings depuis le même serveur. lemonade-server.ai
- Lemonade embarquable
- Un exécutable autonome que les développeurs glissent dans leur application pour lui donner une IA locale adaptée au PC de l'utilisateur. github.com
- Alias de modèles
- Des noms stables qui pointent vers un modèle : on change de modèle sans toucher aux applications qui s'en servent. github.com
- Relais vers le cloud
- Fonction expérimentale qui ajoute au catalogue des modèles d'un fournisseur en ligne compatible OpenAI (OpenAI, OpenRouter, Together, Fireworks). github.com
Pour qui
Propriétaires de PC à processeur AMD Ryzen AI ou carte Radeon qui veulent des modèles locaux sans réglage, et développeurs qui veulent brancher leurs applications sur un serveur compatible OpenAI ou embarquer le moteur dans leur logiciel. github.com
Ce qu'il faut savoir
- Local ou en ligne
- Les modèles tournent sur l'ordinateur ; le réseau sert à télécharger les modèles depuis Hugging Face ou ModelScope. Le relais expérimental vers un fournisseur en ligne, s'il est configuré, envoie les requêtes concernées à ce fournisseur. github.com
- Limites
- Le NPU ne sert que sur les processeurs Ryzen AI 300 et plus récents (XDNA2) ; aucun moteur ne prévoit de gérer celui des Ryzen 7000, 8000 et 200. Le calcul partagé entre NPU et puce graphique (Ryzen AI SW) ne fonctionne que sous Windows ; sous Linux, le NPU passe par FastFlowLM. github.com
- Limites
- Sur PC Intel ou NVIDIA, Lemonade tourne sur le processeur ou sur la carte graphique via Vulkan. Sur Mac, il n'utilise que llama.cpp avec Metal, sur puce Apple Silicon. github.com
- Confidentialité
- Selon l'éditeur, le logiciel n'envoie rien sur le réseau sans qu'on le demande ; il contacte Hugging Face ou ModelScope pour télécharger un modèle. Le site promet « zero telemetry ». github.com
- À noter
- Une nouvelle version sort chaque semaine. lemonade-server.ai
- À noter
- L'appli Lemonade Mobile est publiée au nom d'un développeur particulier (Geramy Loveless). Elle se connecte à un serveur Lemonade ou compatible OpenAI et ne fait tourner aucun modèle sur le téléphone. itunes.apple.com
- Configuration
- Windows 11, Ubuntu 24.04 ou plus, Debian Trixie, Fedora 43 ou plus, Arch Linux, ou macOS sur puce Apple Silicon. NPU : processeurs Ryzen AI 300 et plus récents (XDNA2). Carte graphique : Radeon via ROCm ou Vulkan, NVIDIA Turing ou plus récente via CUDA, Apple Silicon via Metal ; tout processeur x86 fonctionne aussi. Aucune mémoire minimale publiée ; l'éditeur conseille d'ajouter 2 à 4 Go à la taille du modèle. github.com
- Prix
- Gratuit lemonade-server.ai
- Licence
- Open source, licence Apache-2.0. github.com
Modèles
Un catalogue d'environ 260 modèles aux formats GGUF, ONNX et FLM (Llama, Qwen, Gemma, Phi, gpt-oss, DeepSeek…), plus tout GGUF ou ONNX ajouté depuis Hugging Face ou ModelScope. Des modèles d'image (SDXL-Turbo), de voix (Kokoro) et de transcription (Whisper) sont aussi proposés. github.com
- Gemma-4-26B-A4B-it-GGUF
- Gemma-4-31B-it-GGUF
- Gemma-4-E2B-it-GGUF
- Qwen3.5-4B-GGUF
- Qwen3-Coder-Next-GGUF
- gpt-oss-20b-mxfp4-GGUF
- gpt-oss-120b-mxfp-GGUF
- NVIDIA-Nemotron-3.5-Lightning-30B-A3B-GGUF
Les noms surlignés ont leur fiche sur QUELLE IA : score, forces, mémoire demandée.
Captures
iPhone et iPad
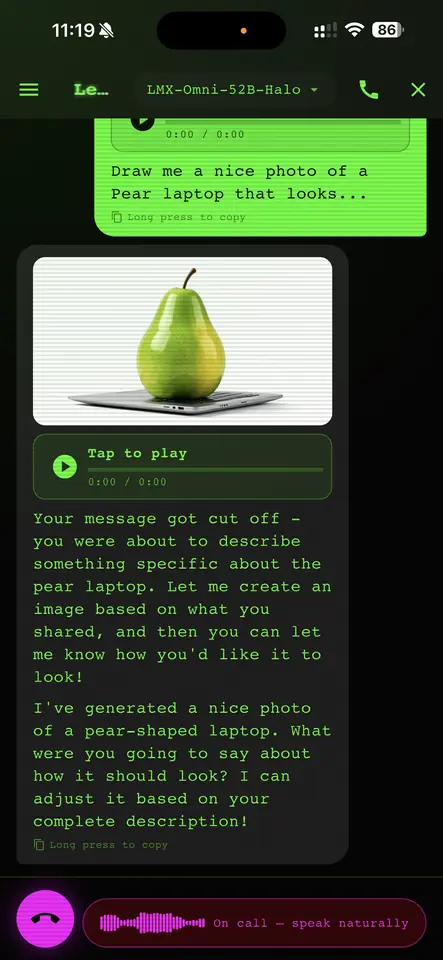
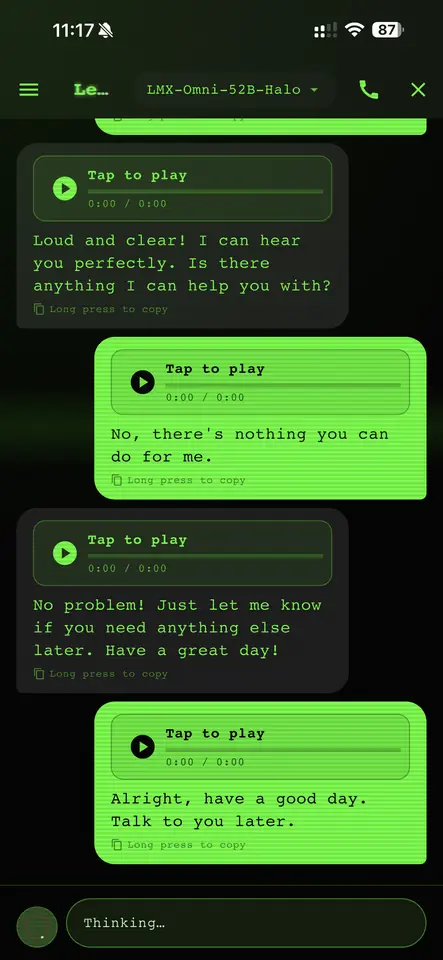
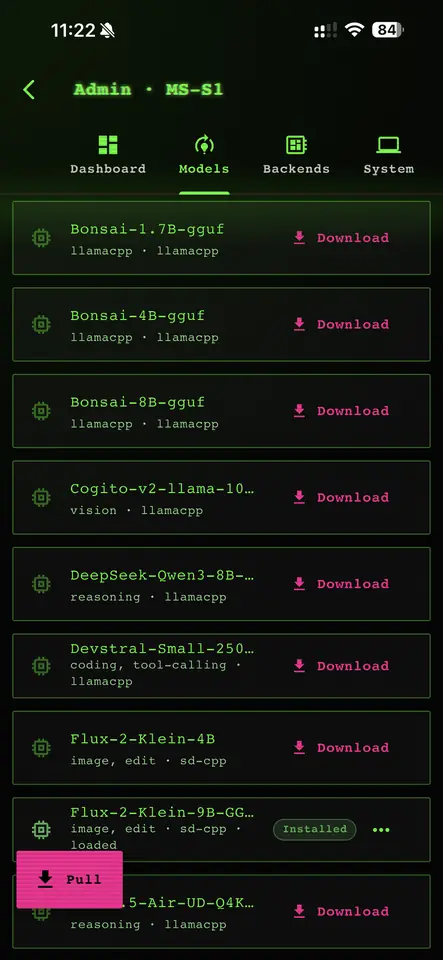
Sur quelles machines
Windows 11, Ubuntu 24.04 ou plus, Debian Trixie, Fedora 43 ou plus, Arch Linux, ou macOS sur puce Apple Silicon. NPU : processeurs Ryzen AI 300 et plus récents (XDNA2). Carte graphique : Radeon via ROCm ou Vulkan, NVIDIA Turing ou plus récente via CUDA, Apple Silicon via Metal ; tout processeur x86 fonctionne aussi. Aucune mémoire minimale publiée ; l'éditeur conseille d'ajouter 2 à 4 Go à la taille du modèle. github.com
Parmi les machines suivies par QUELLE IA (machines Ryzen AI Max, cartes Radeon, Mac), 30 répondent à ce que demande l'éditeur :
- Radeon RX 9060 XT 8 Go
- Radeon RX 9070 GRE
- Mac mini M6, 16 Go
- MacBook Air M5
- MacBook Pro 14 pouces M5
- Radeon RX 9060 XT 16 Go
- Radeon RX 9070
- Radeon RX 9070 XT
- Mac mini M5 Pro, 24 Go
- Mac mini M6, 24 Go
- MacBook Pro M5 Pro
- ASUS ROG Flow Z13 (2025)
Et 18 autres sur Sur ma machine.
Sur QUELLE IA
- Gemma 4 26B A4B Un modèle que Lemonade propose : son score, ses forces, ce qu'il demande.
- Gemma 4 31B IT Un modèle que Lemonade propose : son score, ses forces, ce qu'il demande.
- Quel modèle tient sur ma machine Pour aller plus loin sur l'usage « ia locale sur ordinateur ».
- Les modèles qui tournent en local Pour aller plus loin sur l'usage « ia locale sur ordinateur ».
- Trouver mon modèle Pour aller plus loin sur l'usage « ia locale sur ordinateur ».
- Les outils de code Pour aller plus loin sur l'usage « pour les développeurs ».
Sources
Sources : pages de l'éditeur, des boutiques et du dépôt, .
Société éditrice : Projet communautaire lemonade-sdk, parrainé par AMD.
- github.com/lemonade-sdk/lemonade/blob/main/README.md
- lemonade-server.ai/
- github.com/lemonade-sdk/lemonade/blob/main/docs/guide/faq.md
- lemonade-server.ai/docs/
- play.google.com/store/apps/details?id=com.lemonade.mobile.chat.ai&hl=fr&gl=FR
- github.com/lemonade-sdk/lemonade/blob/main/docs/guide/configuration/cloud.md
- itunes.apple.com/lookup?id=6757372210&country=fr
- github.com/lemonade-sdk/lemonade/releases/latest/download/lemonade.msi
- github.com/lemonade-sdk/lemonade/releases/latest
- lemonade-server.ai/docs/guide/install/linux/
- snapcraft.io/lemonade-server
- apps.apple.com/fr/app/lemonade-mobile/id6757372210
- play.google.com/store/apps/details?id=com.lemonade.mobile.chat.ai
- github.com/lemonade-sdk/lemonade/blob/main/LICENSE
- github.com/lemonade-sdk/lemonade/blob/main/src/cpp/resources/server_models.json
Icône : Geramy Loveless, App Store.
Faire tourner un modèle sur son ordinateur →Apps et logiciels d'IA : tout voir →Signaler une erreur →
Dans le même usage

AI Playground
IntelAI Playground est une application de bureau d'Intel qui réunit conversation, génération et retouche d'images, vidéo, voix et agents, le tout calculé sur le PC.
- Windows
- Linux
gratuitopen source

AnythingLLM
Mintplex LabsAnythingLLM, de Mintplex Labs, sert à discuter avec ses documents et à faire travailler des agents, avec son moteur local intégré ou le fournisseur en ligne de son choix.
- Android
- Mac
- Windows
- Linux
gratuitabonnementopen source
Foundry Local
MicrosoftFoundry Local est le moteur d'IA locale de Microsoft, fait pour être intégré aux applications : un moteur d'environ 20 Mo, des kits de développement (SDK) en C, C++, C#, JavaScript, Python et Rust, et un catalogue restreint de modèles optimisés.
- Mac
- Windows
- Linux
gratuitopen source

Jan
Menlo ResearchJan est une application de bureau libre (Apache 2.0) qui reprend le principe de ChatGPT : on discute avec des modèles locaux, lancés par llama.cpp ou MLX, ou avec des modèles en ligne (OpenAI, Anthropic, Mistral…) grâce à ses propres clés d'API.
- Mac
- Windows
- Linux
gratuitopen source