Anthropic propose quatre modèles actuels, tous avec une fenêtre d’un million de jetons : Haiku 5.5, Sonnet 5.5, Opus 5.5 et Fable 5.2. Ce guide rapporte ce que l’éditeur conseille pour chacun et ce que permet chaque formule ; pour savoir où ils se placent face aux modèles des autres éditeurs, les blocs de classement ci-dessous se mettent à jour chaque semaine.
Comment ça marche
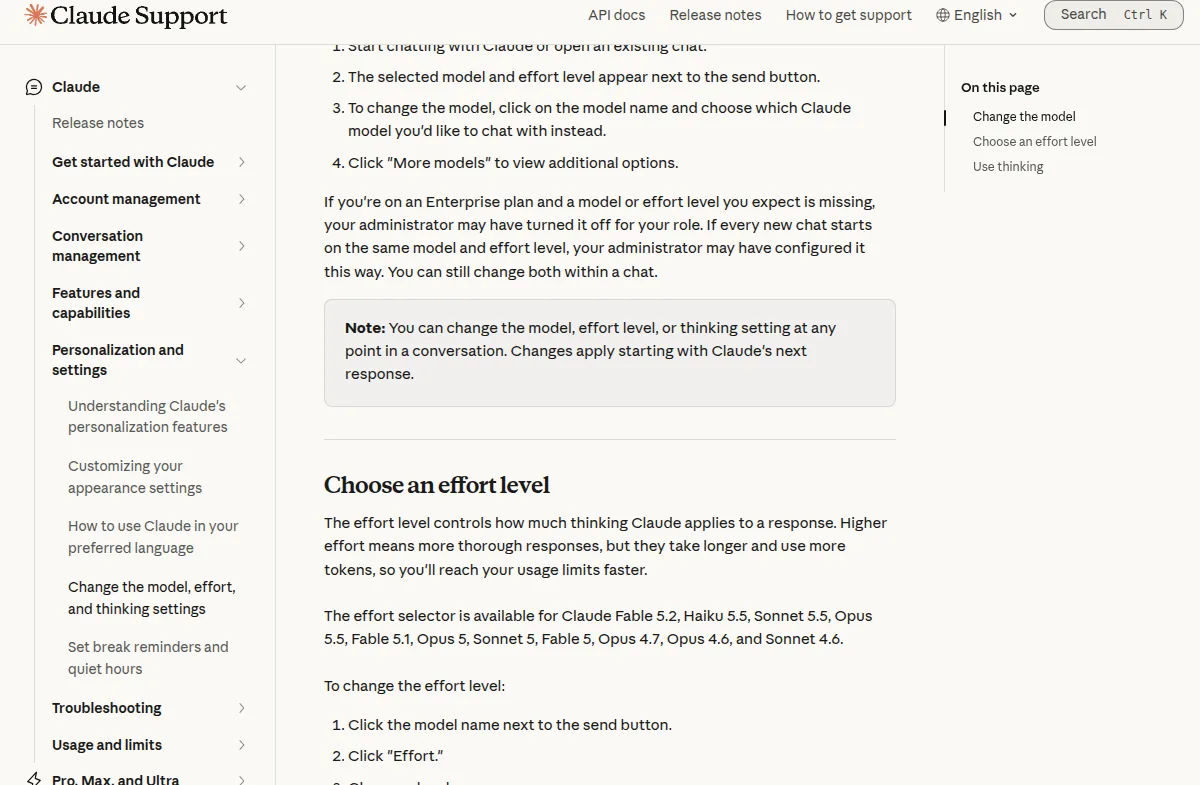
Dans l’appli, le modèle se choisit dans le menu à côté du bouton d’envoi, comme l’effort. Les deux réglages sont distincts : le modèle fixe ce que Claude sait faire, l’effort la quantité de réflexion qu’il y met. Un effort plus élevé donne des réponses plus fouillées, mais plus lentes, et épuise plus vite les limites d’usage. La documentation d’Anthropic juge que régler l’effort est souvent plus utile que changer de modèle.
Ce qu’en dit Anthropic
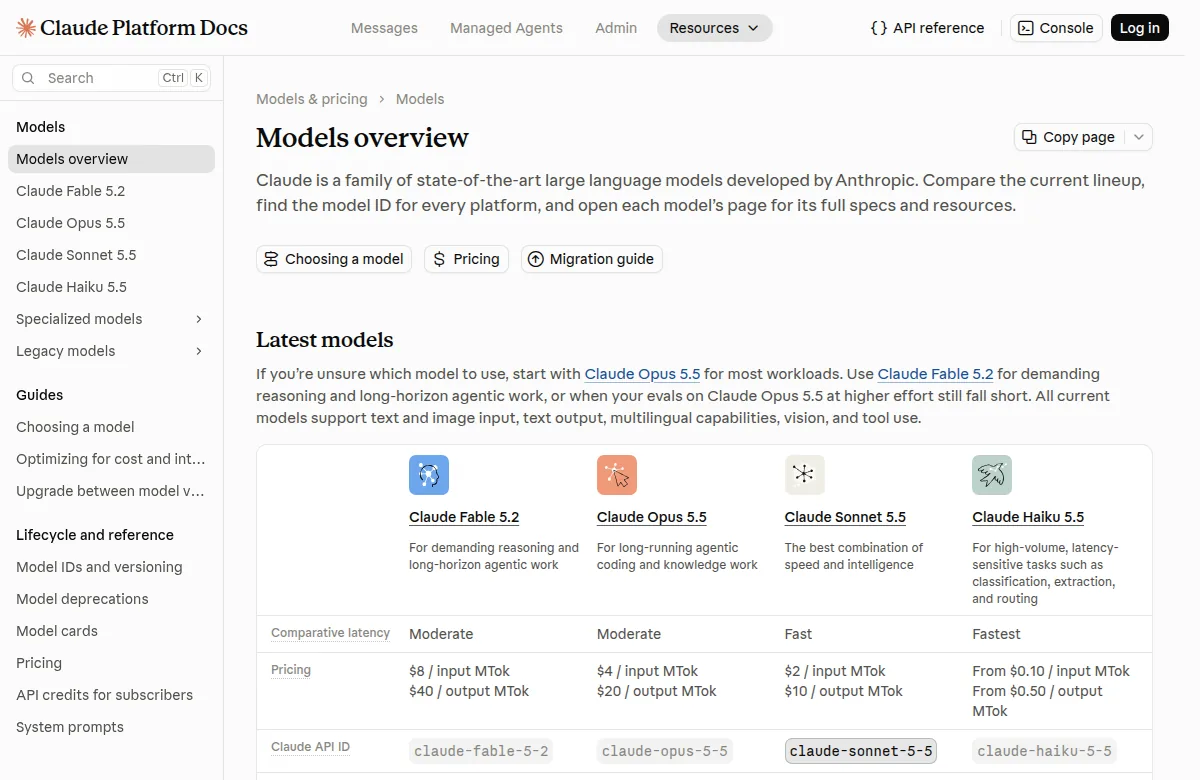
- Opus 5.5 est le point de départ conseillé « pour la plupart des usages » : code et travail intellectuel de longue durée, agents autonomes, analyse d’images, commande de l’ordinateur. Anthropic le dit au niveau de Fable 5.1 sur la plupart des tâches. Effort par défaut : moyen.
- Fable 5.2 sert au raisonnement exigeant et aux agents qui travaillent pendant des heures, ou quand Opus 5.5 ne suffit pas même à effort élevé. C’est le plus cher. Effort par défaut : élevé. Une variante, Mythos 5.2, est réservée aux organisations vérifiées par Anthropic.
- Sonnet 5.5 vise le meilleur compromis entre vitesse et capacités : génération de code, analyse de données, rédaction, documents et présentations. Anthropic le dit plus de 30 % plus rapide que Sonnet 5.
- Haiku 5.5 est le plus rapide et le moins cher : gros volumes, tri, extraction, sous-agents, assistance client en direct. Effort par défaut : moyen.
Lequel choisir pour quoi
- Discuter, rédiger, résumer au quotidien : Sonnet, présent dans toutes les formules, gratuite comprise.
- Un long travail sur des documents ou du code : Opus, à partir de Pro.
- Un problème très difficile ou une tâche d’agent de plusieurs heures : Fable, payé en crédits avec Pro, inclus avec Max et Ultra jusqu’à la moitié de la limite hebdomadaire.
- Beaucoup de petites tâches identiques, surtout par l’API : Haiku.
Les classements de QUELLE IA mesurent ces modèles avec les autres, sur les mêmes bancs publics :
Le haut du classement général
- Claude Fable 5.2Anthropic105,2
- Gemini 4 CarbonGoogle DeepMind102,0
- Claude Opus 5.5Anthropic100,6
- GPT-6 AstraOpenAI100,1
- GPT-6.1 TerraOpenAI99,3
Score IA, édition du 16 novembre 2026. Deux modèles dont les marges se recouvrent sont ex æquo.
Le haut du classement Code
- Claude Opus 5.5Anthropic101,4
- Gemini 4 CarbonGoogle DeepMind100,6
- Claude Fable 5.1Anthropic100,1
- Claude Sonnet 5.5Anthropic99,8
- GPT-6 AstraOpenAI99,3
Score Code, édition du 16 novembre 2026. Deux modèles dont les marges se recouvrent sont ex æquo.
Le haut du classement Français
- Claude Opus 5.5Anthropic100,9
- GPT-6.1 SolOpenAI100,1
- Gemini 3.7 FlashGoogle DeepMind99,8
- Gemini 3.6 FlashGoogle DeepMind99,0
- GPT-6 AstraOpenAI98,7
Score Français, édition du 16 novembre 2026. Deux modèles dont les marges se recouvrent sont ex æquo.
Régler pas à pas dans l’appli
- Ouvrez une conversation : le modèle et l’effort sont affichés à côté du bouton d’envoi.
- Cliquez sur le nom du modèle, choisissez-en un autre, ou « More models » pour la liste complète.
- Cliquez sur « Effort » et choisissez un niveau : Low et Medium pour les tâches courantes, High pour l’équilibre, Extra high pour le code et les agents de longue durée, Max pour la réflexion la plus poussée. Le niveau conseillé porte la mention « Default ».
- Le changement vaut dès la réponse suivante, en cours de conversation.
Sur Fable 5.2, Opus 5.5, Sonnet 5.5 et Haiku 5.5, la réflexion ne se coupe pas dans l’appli : pour qu’il réfléchisse moins, baissez l’effort.
Disponible en France ?
Oui. La grille des tarifs ouverte depuis la France donne Sonnet et Haiku à toutes les formules, Opus à partir de Pro, et Fable aux formules payantes, en crédits d’utilisation pour Pro.
Les formules grand public, en France
- ChatGPTOpenAIFree : Gratuit · Go : 8 € · Plus : 23 € · Pro : dès 103 €
- ClaudeAnthropicFree : Gratuit · Pro : 20 $ · Max : 100 $ · Ultra : 200 $
- GeminiGoogleSans frais : Gratuit · Google AI Plus : 4,99 € · Google AI Pro : 21,99 € · Google AI Ultra : dès 99,99 €
- Vibe (ex-Le Chat)Mistral AIFree : Gratuit · Pro : 17,99 €
- Microsoft CopilotMicrosoftCopilot gratuit : Gratuit · Microsoft 365 Personnel : 10 € · Microsoft 365 Famille : 13 € · Microsoft 365 Premium : 22 € · Microsoft 365 Professionnel : 110 €
- PerplexityPerplexityGratuit
- GrokxAIGratuit · Plus : 8 € · Premium : 31 € · Super : 105 € · Ultra : 210 €
- Meta AIMetaGratuit · Meta One Core : 6,99 € · Meta One Premium : 20,99 €
- DeepSeekDeepSeekGratuit
- Qwen ChatAlibabaGratuit
- KimiMoonshot AIAdagio : Gratuit · Plus : 19 $ · Pro : 39 $ · Max : 99 $ · Ultra : 199 $
- LumoProtonGratuit · Lumo AI Plus : 12,99 €
Prix par mois affichés en France sur la page officielle de chaque assistant, relevés au plus tard le 17 novembre 2026. Vérifiez avant de payer.
Limites et précautions
- Fable épuise vite les limites. Avec Max et Ultra, il puise dans la limite hebdomadaire plus vite que les autres modèles ; au-delà de sa part, il se paie en crédits.
- Fable ne parle pas. Le mode vocal ne le propose pas.
- Un nom de famille ne suffit pas. Dans la grille des tarifs, « Opus » ou « Sonnet » désigne la famille ; la version vient des pages des modèles. Vérifiez la version affichée dans le sélecteur.
Pour aller plus loin
- Claude fable 5 2
- Claude opus 5 5
- Claude sonnet 5 5
- Claude haiku 5 5
- Anthropic
- Classement général
- Claude
- Modèle de réflexion : penser avant de répondreNiveau Débutant 2 min
- L'API de Claude : console, prix, effort et cacheNiveau Expert 15 min
- Quel abonnement d'IA choisir en FranceNiveau Débutant 6 min
- Lire le score de QUELLE IA : marge, rang et ex æquoNiveau Débutant 3 min
- Gemini : quel modèle choisir, de Flash-Lite à CarbonNiveau Débutant 8 min
- Par où commencer avec l'IA : quatre parcoursNiveau Débutant 5 min
- Quel effort de réflexion choisir pour une IA, et quandNiveau Amateur 10 min
Sur mini lab AI, un guide du même auteur reprend ce sujet pour monter son atelier d'IA à la maison.
Sources
- Claude Platform Docs, Models overview, lue le
- Claude Platform Docs, Choosing the right model, lue le
- Claude Help Center, Change the model, effort, and thinking settings, lue le
- Claude Help Center, Claude Fable models on your plan, lue le
- Claude, Plans et tarifs, lue le
- Anthropic, Introducing Claude Opus 5.5, lue le
- Anthropic, Introducing Claude Sonnet 5.5, lue le
- Anthropic, Introducing Claude Haiku 5.5, lue le