Mistral Large 4 est le plus grand modèle publié par Mistral AI. L’éditeur l’a ouvert en préversion par son API le 6 octobre 2026, en le surnommant « le Chonk ». Le 29 octobre, il a publié une version améliorée avec ses poids, que tout le monde peut télécharger sur Hugging Face. Mistral le décrit comme un modèle généraliste, qui lit du texte et des images et qui sait raisonner avant de répondre.
Comment il est construit
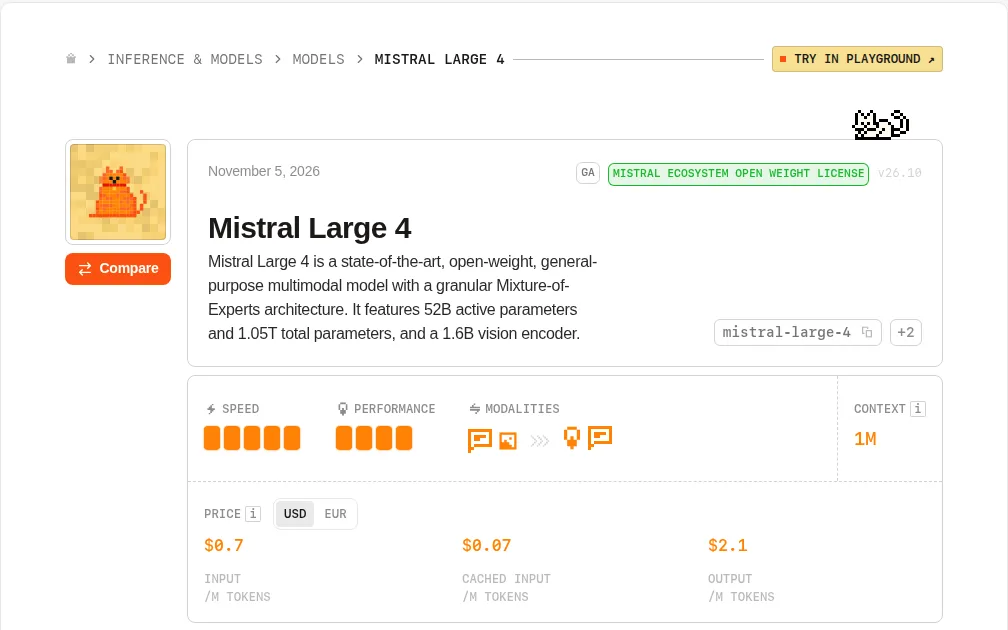
La carte du modèle sur Hugging Face donne l’essentiel. Mistral Large 4 compte environ 1 000 milliards de paramètres, mais seulement 49 milliards travaillent pour chaque jeton (52 milliards en comptant les couches d’entrée et de sortie). La documentation de Mistral arrondit autrement et annonce « 52B active parameters and 1.05T total parameters », auxquels s’ajoute un encodeur d’images de 1,6 milliard de paramètres.
Cette architecture s’appelle un mélange d’experts. Le modèle est découpé en 128 blocs spécialisés, les experts. Pour chaque jeton, un routeur en choisit quatre, auxquels s’ajoute un expert partagé qui sert toujours. Le calcul de chaque jeton demande ainsi à peu près autant d’opérations qu’un modèle de 50 milliards de paramètres. Toute la mémoire reste nécessaire, en revanche : les 128 experts doivent être chargés, même s’ils ne servent pas tous en même temps.
Les autres caractéristiques publiées par Mistral :
- Contexte : un million de jetons, soit la place pour plusieurs livres dans une même conversation (voir le guide Fenêtre de contexte).
- Entrées : du texte et des images, avec une sortie en texte. Mistral met en avant la lecture de graphiques, de schémas techniques et de documents.
- Langues : plus de 160, dont toutes les langues officielles de l’Union européenne.
- Entraînement : à partir de zéro, sur 3 800 GPU NVIDIA Grace Blackwell des centres de données de Mistral en Europe.
- Licence : la Mistral Ecosystem Open-Weight License, une licence MIT modifiée. L’usage commercial est permis, sauf pour une entreprise qui vend l’accès au modèle sous forme de service (« Model-as-a-Service ») : elle doit signer une licence à part avec Mistral.
Bon à savoir. Mistral Large 3 était sous licence Apache 2.0, qui n’impose rien de tel. Numerama note que la licence de Large 4 est « moins généreuse » sur ce point.
De la préversion à la version finale
Le 6 octobre 2026, Mistral ouvre une préversion publique par l’API, sous l’identifiant mistral-large-4. Il prévient que l’entraînement continue et promet les poids « à la fin du mois ». Le 29 octobre, il publie les poids et une version qu’il dit nettement meilleure en code et en cybersécurité, après trois semaines d’apprentissage par renforcement supplémentaires.
Le registre légal de Mistral distingue les deux : « Mistral Large 4 - Preview Version », sortie le 6 octobre et marquée « Retired », et « Mistral Large 4 », sortie le 29 octobre et « Active ». La fiche de la documentation, elle, date la disponibilité générale (GA) du 5 novembre 2026, en version 26.10.
La version finale a changé deux choses pour les développeurs. Le prix de l’API a été divisé par deux, et le réglage de la réflexion a changé de forme (détails plus bas).
La réflexion réglable
Mistral Large 4 raisonne toujours avant de répondre. Le paramètre reasoning_effort règle l’effort qu’il y consacre, avec trois valeurs :
lowpour les tâches simples, en remplacement du mode « none » de la préversion, qui n’existe plus ;mediumpour l’usage courant ;highpour les tâches complexes et les agents, la valeur par défaut.
Plus l’effort est haut, plus le modèle écrit de jetons de réflexion, facturés comme des jetons de sortie. La documentation recommande de partir de high, puis de descendre si la latence ou le coût comptent davantage. Le guide Modèle de réflexion explique le principe.
Où l’utiliser
- Par l’API de Mistral, sous les noms
mistral-large-4,mistral-large-4-0oumistral-large-latest. On le teste sans code dans le bac à sable (« playground ») de Studio. Le guide L’API de Mistral et Studio montre le premier appel. - Dans l’agent de code Vibe, où la documentation le présente comme le modèle phare (« Flagship reasoning and code »), sous l’identifiant
mistral-large-4-0. Voir le guide Coder avec Vibe. - Chez d’autres fournisseurs : Mistral cite OpenRouter, Microsoft Foundry et les points d’accès hébergés par NVIDIA. Ollama ne le propose qu’en version « cloud » (
mistral-large-4:cloud), qui tourne sur les serveurs d’Ollama. - Sur vos propres serveurs, avec les poids de Hugging Face et vLLM ou SGLang.
Dans l’assistant Vibe, la page du produit montre « Mistral Large 4 » dans la barre de saisie de son aperçu. La page de tarifs ne dit pas quelles formules y donnent accès.
Ce qu’il coûte par l’API
La documentation affiche, par million de jetons : 0,7 $ en entrée, 0,07 $ en entrée mise en cache et 2,1 $ en sortie. Le billet du 29 octobre donne les mêmes montants (0,70 $, 0,07 $ et 2,10 $). Pendant la préversion, le tarif standard était de 1,36 $ en entrée et 4,18 $ en sortie, rappelle Numerama. La fiche du modèle sur QUELLE IA traduit ces tarifs en coût estimé pour mille questions.
Le faire tourner chez soi
Le dépôt officiel pèse environ 1 060 Go. La carte donne un exemple de serveur vLLM réparti sur huit cartes graphiques, et une version compressée NVFP4 existe pour les puces Blackwell de NVIDIA. Selon Frandroid, Mistral cite quatre GPU de centre de données NVIDIA B200 ou B300 pour cette version compressée.
La fiche de QUELLE IA l’estime à 690 Go en version allégée à 4 bits, au-delà des machines que suit le site. Unsloth publie des versions bien plus compressées, de 233 Go en 1 bit à 605 Go pour sa version 4 bits, mais la perte de qualité de ces réglages extrêmes n’est pas mesurée. Le 28 octobre, Mistral a annoncé à Frandroid une famille de modèles plus petits « dans le mois qui vient », dont l’un tournerait sur un PC portable. Le 17 novembre, aucun dépôt de ce type ne figurait encore sur la page Hugging Face de Mistral.
Sa place dans le classement
QUELLE IA ne recopie pas les chiffres de Mistral : la fiche du modèle les montre à part, sous « Annoncé par Mistral AI ». Mistral met en avant la cybersécurité, la finance, le droit et la lecture d’images, et cite par exemple 19,7 % sur FrontierCode 2.0, un banc privé de la société Cognition. Le classement du site repose sur les benchmarks publics où le modèle a été mesuré :
Le haut du classement général
- Claude Fable 5.2Anthropic105,2
- Gemini 4 CarbonGoogle DeepMind102,0
- Claude Opus 5.5Anthropic100,6
- GPT-6 AstraOpenAI100,1
- GPT-6.1 TerraOpenAI99,3
Score IA, édition du 16 novembre 2026. Deux modèles dont les marges se recouvrent sont ex æquo.
En programmation :
Le haut du classement Code
- Claude Opus 5.5Anthropic101,4
- Gemini 4 CarbonGoogle DeepMind100,6
- Claude Fable 5.1Anthropic100,1
- Claude Sonnet 5.5Anthropic99,8
- GPT-6 AstraOpenAI99,3
Score Code, édition du 16 novembre 2026. Deux modèles dont les marges se recouvrent sont ex æquo.
Si Mistral Large 4 n’apparaît pas dans ces listes, sa fiche donne son rang exact et ses scores par tâche, avec leur marge.
Exemples de demandes à essayer
Voici le schéma électrique en pièce jointe. Liste chaque composant avec sa référence, puis signale les connexions qui te semblent incohérentes.
Lis ce contrat de 80 pages et dresse un tableau des clauses de résiliation : délai, conditions, pénalités, article concerné.
Traduis cette notice en polonais et en grec, en gardant les unités et la mise en forme Markdown.
Pour aller plus loin
- Mistral large 4
- Mistral ai
- Les nouveaux modèles
- Mistral Vibe
- Quel modèle sur ma machine
- Classement général
- L'API de Mistral et Studio : clé, premier appel, prix, agentsNiveau Expert 16 min
- Coder avec Vibe de Mistral : terminal, VS Code et Vibe DesktopNiveau Amateur 15 min
- Les modèles Mistral en local avec Ollama ou LM StudioNiveau Amateur 12 min
- Modèle de réflexion : penser avant de répondreNiveau Débutant 2 min
- Fenêtre de contexte : ce que veut dire « 1 million de jetons »Niveau Débutant 2 min
- Adobe Firefly : le studio d'IA d'Adobe et ses modèles partenairesNiveau Débutant 10 min
- Anthropic et Claude : les produits, les modèles et les formulesNiveau Débutant 12 min
- Bien démarrer avec ChatGPT sur le web, l'ordinateur et le mobileNiveau Débutant 12 min
Pour monter son atelier d'IA à la maison, mini lab AI, du même auteur, va plus loin.
Sources
- Mistral AI, Présentation de Mistral Large 4 (6 octobre 2026), lue le
- Mistral AI, Mistral Large 4 (Le Chonk) is now open weight (29 octobre 2026), lue le
- Documentation de Mistral, fiche Mistral Large 4, lue le
- Mistral AI, Legal Center, cycle de vie de Mistral Large 4, lue le
- Hugging Face, carte de mistralai/Mistral-Large-4-1T-A52B, lue le
- Hugging Face, versions GGUF d'Unsloth, lue le
- Documentation de Mistral, Reasoning, lue le
- Documentation de Mistral, API pricing, lue le
- Documentation de Mistral, configuration de Vibe Code, lue le
- Ollama, bibliothèque, mistral-large-4, lue le
- Frandroid, « Il tournera sur PC portable » : Mistral nous confirme un Large 4 allégé (29 octobre 2026), lue le
- Numerama, Nettement meilleur en code, Mistral Large 4 débarque enfin sur Hugging Face (30 octobre 2026), lue le