GPT-5.5
OpenAI · États-Unis · sorti le OpenAI · États-Unis · 23 avril 2026
- Réflexion réglable
- Poids fermés
- En ligne seulement
- Classe énergétique E
Son bilan?
- Dans le top 20 du classement général, 18e sur 257, dans un peloton de 11 modèles que la marge d'erreur ne permet pas de séparer.
- Dans le top 10 en tâches d'agent (8e) et sciences (10e).
- En retrait en création web (55e).
Estimationenviron 17 € pour 1 000 questions par l'API, en comptant 1 000 jetons lus et 500 écrits par question. Comment on l'estime
Score général?
91,0de 89,7 à 92,4
Les dix tâches?
- Raisonnement94,5Rang 12 · 89 %, voir le classement Raisonnement
- Code89,7Rang 23 · 75 %, voir le classement Code
- Agents90,5Rang 8 · 88 %, voir le classement Agents
- Usage90,2Rang 20 · 100 %, voir le classement Usage
- Maths91,6Rang 17 · 100 %, voir le classement Maths
- Sciences95,3Rang 10 · 80 %, voir le classement Sciences
- Français91,6Rang 11 · 50 %, voir le classement Français
- Vision92,1Rang 13 · 100 %, voir le classement Vision
- Écriture90,2Rang 22 · 100 %, voir le classement Écriture
- Web85,2Rang 55 · 100 %, voir le classement Web
Artificial Analysis
Hors du scoreArtificial Analysis évalue les modèles de son côté et publie son propre indice, l'Artificial Analysis Intelligence Index. C'est un autre indice, qui ne compte pas dans le score IA de QUELLE IA et ne se compare pas directement à lui.
| Version évaluée | Indice | Rang chez eux | Vitesse | Premier jeton | Prix par million de jetonsentrée / sortie |
|---|---|---|---|---|---|
| GPT-5.5 (Xhigh) | 38,4 | non publié | 0,0 jetons/s | 0,00 s | 5 $ / 30 $ |
| GPT-5.5 (High) | 37,0 | non publié | 0,0 jetons/s | 0,00 s | 5 $ / 30 $ |
| GPT-5.5 (Medium) | 33,8 | non publié | 0,0 jetons/s | 0,00 s | 5 $ / 30 $ |
| GPT-5.5 (Low) | 30,7 | non publié | 0,0 jetons/s | 0,00 s | 5 $ / 30 $ |
| GPT-5.5 (Non-reasoning) | 23,2 | non publié | 0,0 jetons/s | 0,00 s | 5 $ / 30 $ |
Médianes de leurs mesures : vitesse en jetons produits par seconde, délai avant le premier jeton en secondes. Prix en dollars par million de jetons, en entrée puis en sortie. Relevé le 26 octobre 2026 sur leur site, reproduit avec leur accord.
Source : Artificial Analysis
Peut-il tourner chez vous ?
Non. GPT-5.5 est un modèle fermé : il s'utilise en ligne, par l'application de son éditeur ou par API.
- MiMo-V2.6 Pro · Serveur91,0
- DeepSeek V4.1 Flash 1017 · 4 DGX Spark, 512 Go91,3
- Kimi K3 · Serveur90,0
Ces trois modèles ouverts ont le score le plus proche. Eux se téléchargent, et peuvent tourner sur votre machine ou sur votre serveur.
Fiche technique
- Prix
- 4,34 € / 26,0 €entrée / sortie, par million de jetons
- Fenêtre de contexte
- 1 050 000 jetonsenviron 788 000 mots
- Entrées
- Texte, image, PDF
- Réflexion
- Sans, faible, moyenne, élevée, très élevéecinq niveaux réglables
- Paramètres
- Non communiqué
- Licence
- Propriétairepoids fermés, accès par l'éditeur
- Classe énergétique
- Esur une échelle de A à G
- Hébergement en Europe
- Possible
- Connaissances jusqu'à
- Décembre 2025
Où le trouver
Liens directs, sans affiliationDans les outils de code
Relevé du- Disponible dans
- Mesuré dans
Un modèle proposé par un outil figure dans la liste que son éditeur publie. Rien n'y est mesuré. Tous les outils et leurs modèles →
Selon l'outil
Le même modèle n'obtient pas le même score selon l'outil qui le pilote. Ces mesures viennent des classements publics, une par outil.
GPT-5.5 sur Terminal-Bench 2.0
4 outils · écart de 18,7 pointsautre agentoutil grand public
Modèle sorti le 23 avril 2026 · source : tbench.ai
Le classement Terminal-Bench date chaque ligne du jour de sortie du modèle et ne publie pas la date de chaque mesure.
À lire sur Frandroid, Numerama et Clubic
4 articles · relevé du- Clubic
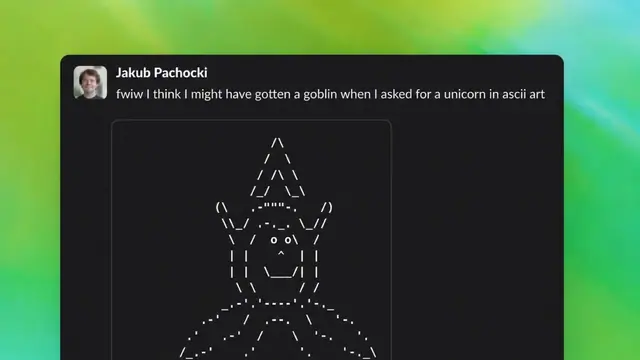 L’incroyable tic de l’IA : quand GPT-5.5 refuse d'arrêter de parler de créatures imaginairesPhoto : Clubic
- Numerama
 OpenAI dévoile GPT-5.5 et veut faire une remontada historique face à Claude et GeminiPhoto : Numerama
- Frandroid
 OpenAI dégaine GPT-5.5 : « son modèle le plus intelligent et le plus intuitif à ce jour » pour battre GeminiPhoto : Frandroid
Une sélection automatique des articles de Frandroid, Numerama et Clubic consacrés à ce modèle. Ces trois médias appartiennent au groupe Humanoid. Les articles n'entrent pas dans le score.
En bref
- Quel est le score de GPT-5.5 ?
- GPT-5.5 obtient un score IA de 91,0, avec une marge de 89,7 à 92,4, dans l'édition du 9 novembre 2026. Il est classé 18e sur 257 modèles, à partir de 44 mesures.?
- Dans quelles tâches GPT-5.5 est-il le plus fort ?
- Ses deux meilleures tâches sont sciences (95,3) et raisonnement (94,5). Sa tâche la plus faible est web (85,2).
- GPT-5.5 peut-il tourner en local ?
- Non. GPT-5.5 est un modèle fermé : il s'utilise en ligne, par l'application de son éditeur ou par API.
- Combien coûte GPT-5.5 ?
- 4,34 € par million de jetons en entrée et 26,0 € en sortie, au tarif affiché par les fournisseurs. Pour fixer les idées, 1 000 questions de 1 000 jetons, avec des réponses de 500 jetons, coûteraient environ 17 € par l'API : c'est une estimation, pas un tarif. Le coût réel d'une tâche dépend du nombre de jetons que le modèle consomme.
- Qui édite GPT-5.5 ?
- GPT-5.5 est édité par OpenAI (États-Unis), et il est sorti le 23 avril 2026. C'est un modèle fermé.